| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- argocd
- 스프링 부트
- DI
- 도메인
- Helm
- docker
- 쿠버네티스
- securitycontextholderfilter
- kafka
- Spring
- Web
- 페이징
- MSA
- dockerhub
- redis
- 컨테이너
- JPQL
- JWT
- @Transactional
- JdbcTemplate
- AWS
- mybatis
- cicd
- Spring Container
- Spring Data JPA
- JPA
- CORS
- Iam
- Secret
- k8s
- Today
- Total
look-forest
쿠버네티스 아키텍처와 리소스 본문
쿠버네티스는 클러스터 기반으로 구성되어 있고, 클러스터는 컨테이너화된 애플리케이션을 실행하기 위한 컴퓨터(노드)의 집합.
클러스터와 컴포넌트
쿠버네티스 클러스터는 크게 마스터 노드(컨트롤 플레인)와 워커 노드(데이터 플레인)로 구성.
- 컨트롤 플레인: "무엇을, 어디에, 어떻게" 실행할지 결정하는 관리 계층
- 데이터 플레인: 그 결정에 따라 실제로 컨테이너를 실행하는 작업 계층
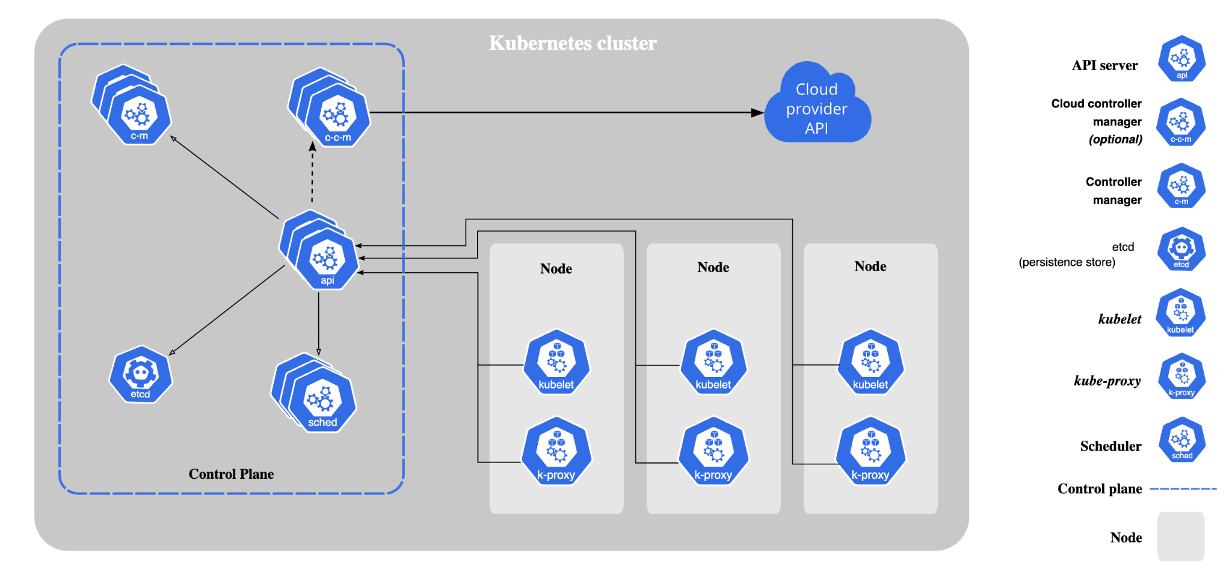
마스터/워커 노드를 구성하기 위해서는 kubeadm(설치마법사)를 이용해서 k8s 관련 바이너리를 설치하고, 관련 설정을 해야한다. (container runtime도 설치되어 있어야 한다)
Master Node (Control Plane)
컨트롤 플레인의 역할은 클러스터의 현재 상태(Current State)를 파악하고, 클러스터를 원하는 상태(Desired State)로 이동시키기 위한 결정을 내리는 것이다.
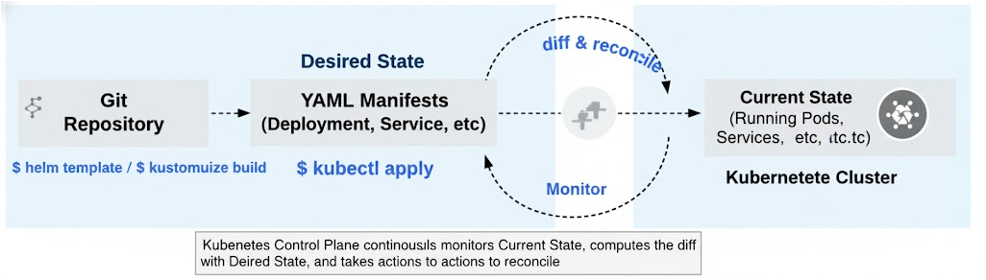
보통 프로덕션 환경에서는 컨트롤 플레인을 여러 대로 이중화(HA)해서 사령탑이 죽어도 클러스터가 계속 돌아가게 구성한다.
(다만 컨트롤 플레인이 잠깐 죽어도 이미 떠있는 파드들은 데이터 플레인에서 계속 동작한다. 새로운 스케줄링이나 상태 변경만 안 될 뿐)
마스터노드의 안정성, 고가용성은 매우 중요하지만 aws의 eks는 클러스터 생성시 마스터노드의 생성 및 관리를 지원한다.
주요 요소
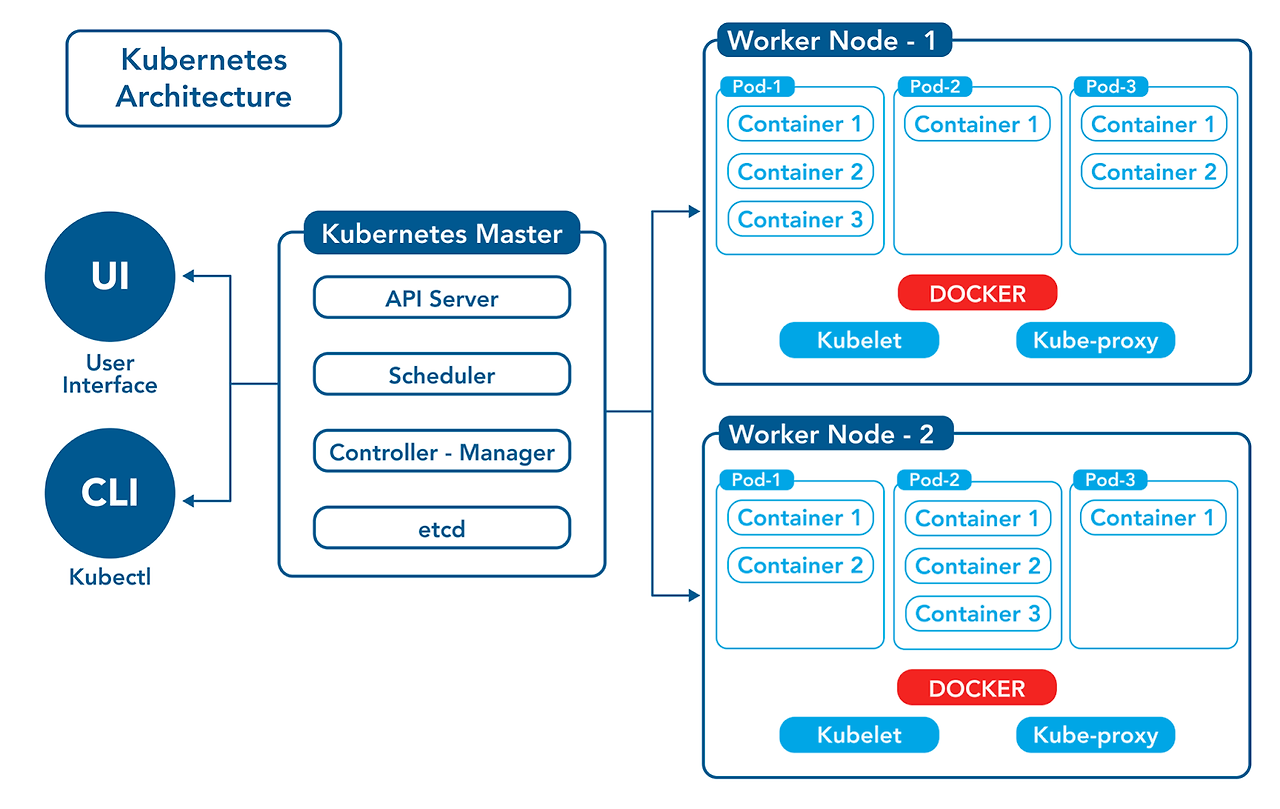
- API server: 모든 요청의 진입점. kubectl, 다른 컴포넌트들이 여기를 거쳐 클러스터와 통신.
- scheduler: 리소스 활용도와 애플리케이션 성능을 최적화. 파드의 요구 사항을 고려하여, 적절한 노드에 파드를 배치.
- controller-manager: 쿠버네티스 리소스를 모니터링하고, 실제 상태가 사용자가 정의한 최종 상태에 맞게 조정.
- etcd: 클러스터 상태 저장소. 모든 클러스터 상태값(ConfigMap 등)를 key-value 형태로 저장하는 고가용성 분산 DB.
Worker Node (Data Plane)
애플리케이션의 실제 실행을 담당하는 노드로서 각 워커 노드에는 Kubelet이라는 에이전트를 실행되어 마스터 노드와 통신
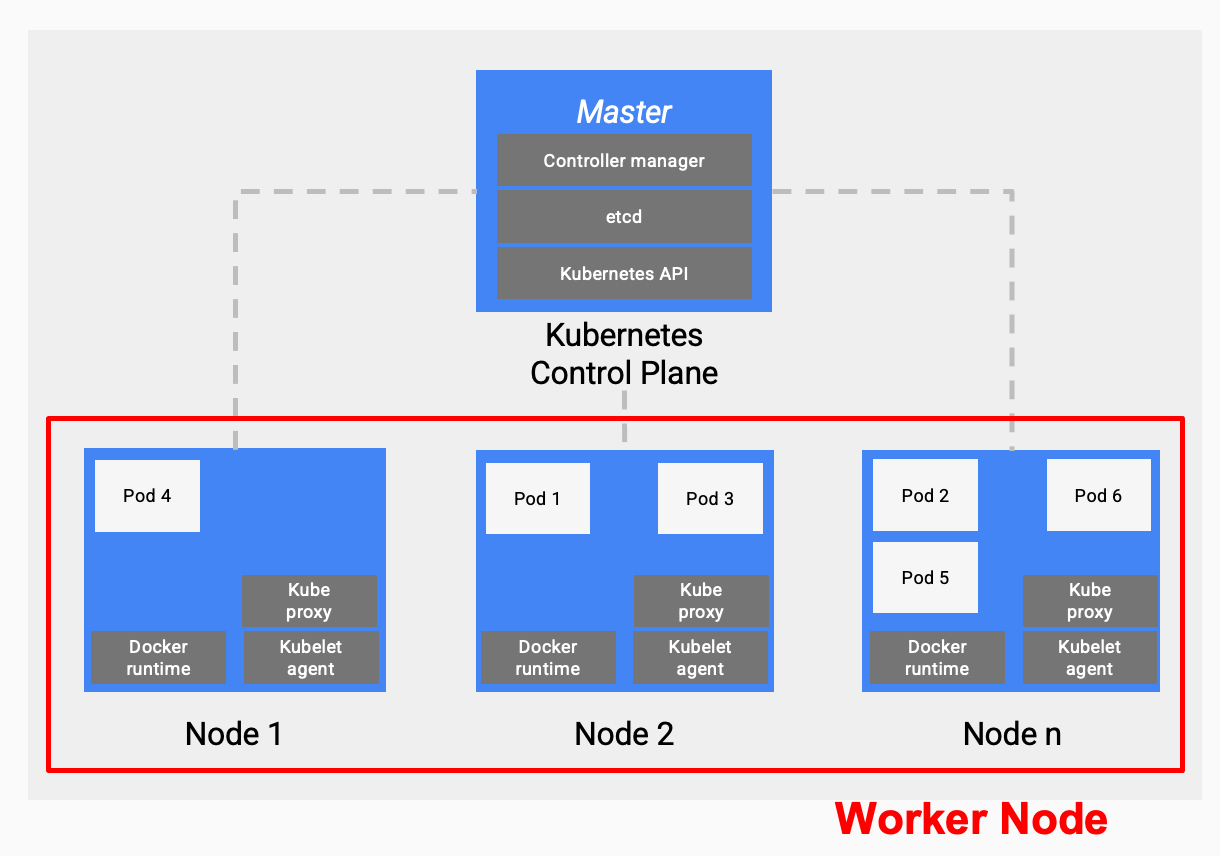
구성 요소
- kubelet: 현장관리자. 각 노드에서 컨트롤 플레인 지시를 받아 파드가 정상 실행되도록 관리 (컨테이너 생성/삭제/헬스체크)
- kube-proxy: 노드 단위 네트워킹 규칙 관리, Service의 트래픽을 올바른 파드로 라우팅
- 컨테이너 런타임 (containerd, CRI-O 등): 실제로 컨테이너를 실행하는 엔진(과거에 도커를 사용했었는데 현재는 conatinerd)
- Pod: 실제 애플리케이션 컨테이너들이 돌아가는 최소 배포 단위
쿠버네티스 리소스
Service, Deployment 등은 마스터/워커 노드에서 실행되는 프로세스(컴포넌트)가 아니라, k8s의 API 오브젝트(리소스)이다.
즉, 컨트롤 플레인이 해석·관리하고 데이터 플레인이 실행에 옮기는 대상인 것이다.
- 컴포넌트 (Component): 실제로 노드에서 실행되는 프로세스/바이너리. (공장의 기계, 관리자, 작업자)
- 리소스 (Resource): etcd에 저장되는 선언적 설정 데이터(YAML). (기계에게 내리는 "작업 지시서")
- Object: 하나의 인프라 개념으로서 단독 기능을 함
- Controller: 타 Controller나 Object를 제어. Object들을 자동화시키려는 목적
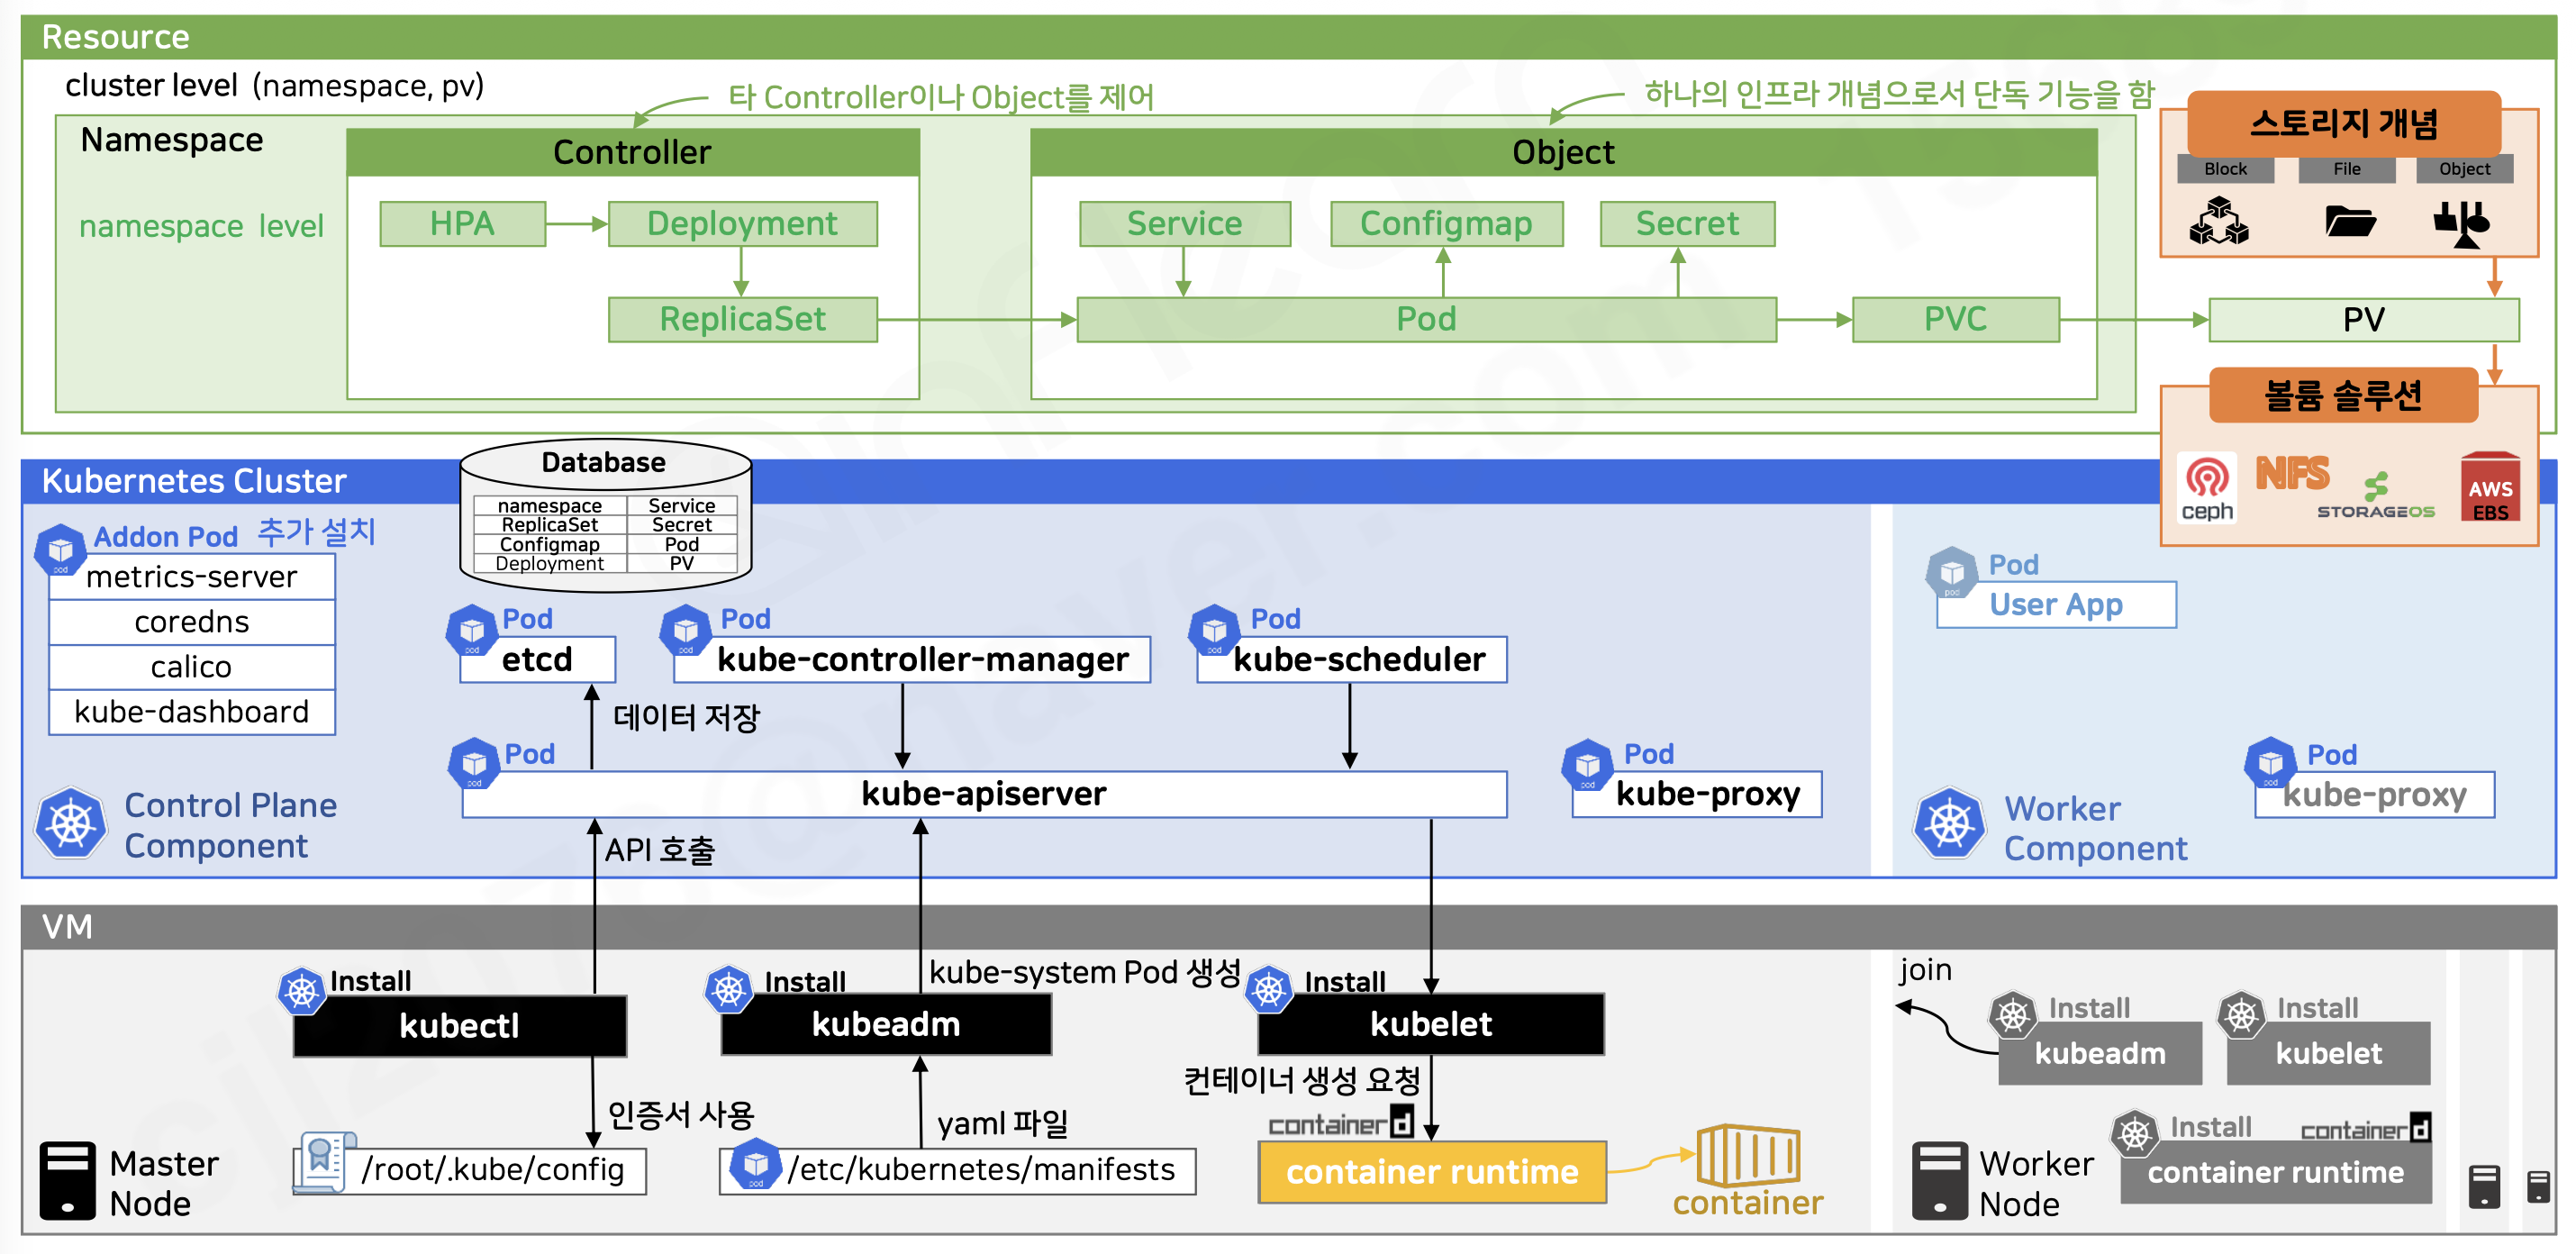
ex. Deployment가 실제로 동작하는 과정
1. 사용자가 Deployment YAML을 kubectl apply
        ↓
2. kube-apiserver가 요청 받아서 etcd에 저장
        ↓
3. kube-controller-manager 안의 "Deployment Controller"가
   etcd를 보고 "아, Pod를 N개 만들어야 하네" 판단
        ↓
4. 그 결과로 ReplicaSet, Pod 오브젝트가 생성됨 (역시 etcd에 저장)
        ↓
5. kube-scheduler가 새로 생성된 Pod를 보고 "어느 워커 노드에 배치할지" 결정
        ↓
6. 해당 워커 노드의 kubelet이 그 정보를 받아서
   실제로 컨테이너 런타임에게 컨테이너 실행을 지시
구성 요소
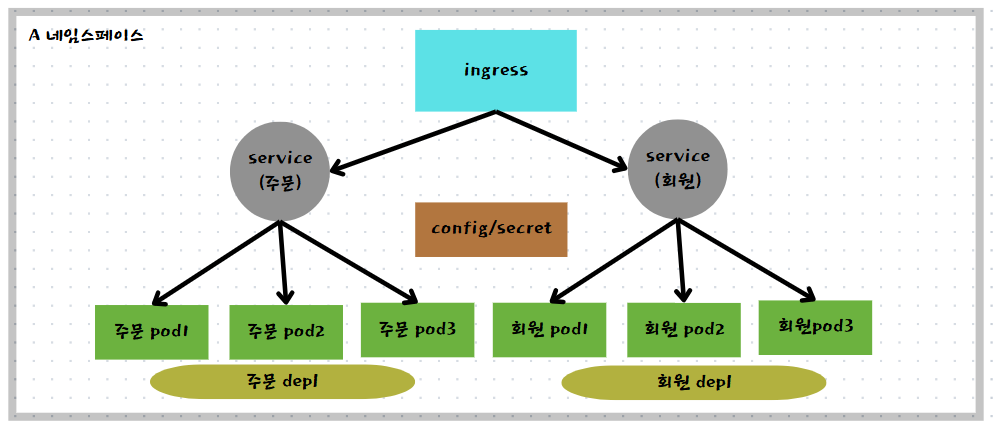
네임 스페이스
- 클러스터 내의 리소스를 "논리적으로" 분리된 그룹으로 나누는 단위.
- 한 클러스터에 dev/prod 환경을 논리적으로 나눠서 지정할 수 있게 해준다. 물리적으로 클러스터를 2개 만드는 것보다 경제적이다.


Pod
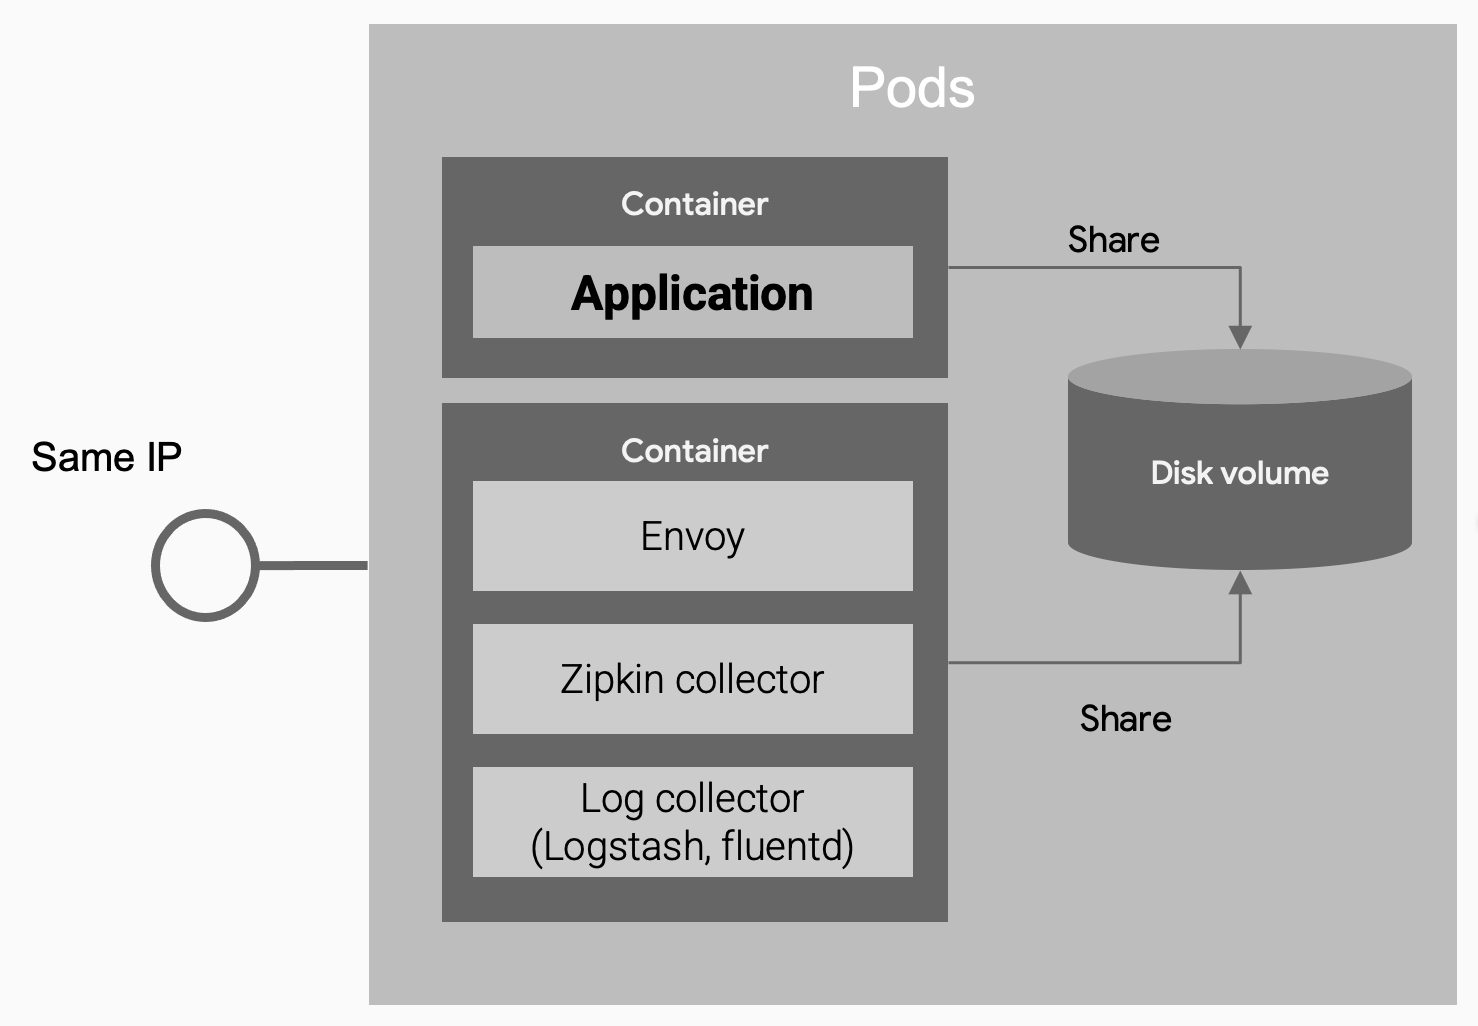
- 쿠버네티스에서 배포할 수 있는 가장 작은 단위이며, 1개 이상의 컨테이너로 구성된 배포 단위(보통 하나로 구성)
- 네트워크 및 볼륨을 공유하는 실행 환경. 리소스와 생명 주기를 공유하는 하나 이상의 컨테이너를 캡슐화
- 일반적으로, 하나의 Pod 내에 여러 컨테이너를 배치해야 하는 상황은 주로 그 컨테이너들이 밀접하게 협력하며, 서로 간에 높은 내부 통신이 필요할 때이다. 아무래도 localhost로 통신할 수 있으니 다른 파드, 서비스와 통신하는 것보다 훨씬 빠르다.
ex) 특정 container의 로그정보 수집, health check, redis와 같은 third party 등 여러개의 컨테이너를 배치하는 경우
ReplicaSet
- Pod 복제 개수 유지
- Pod가 죽거나 사라지면 자동으로 재생성(Self-healing)
- Deployment의 구성요소
Deployment
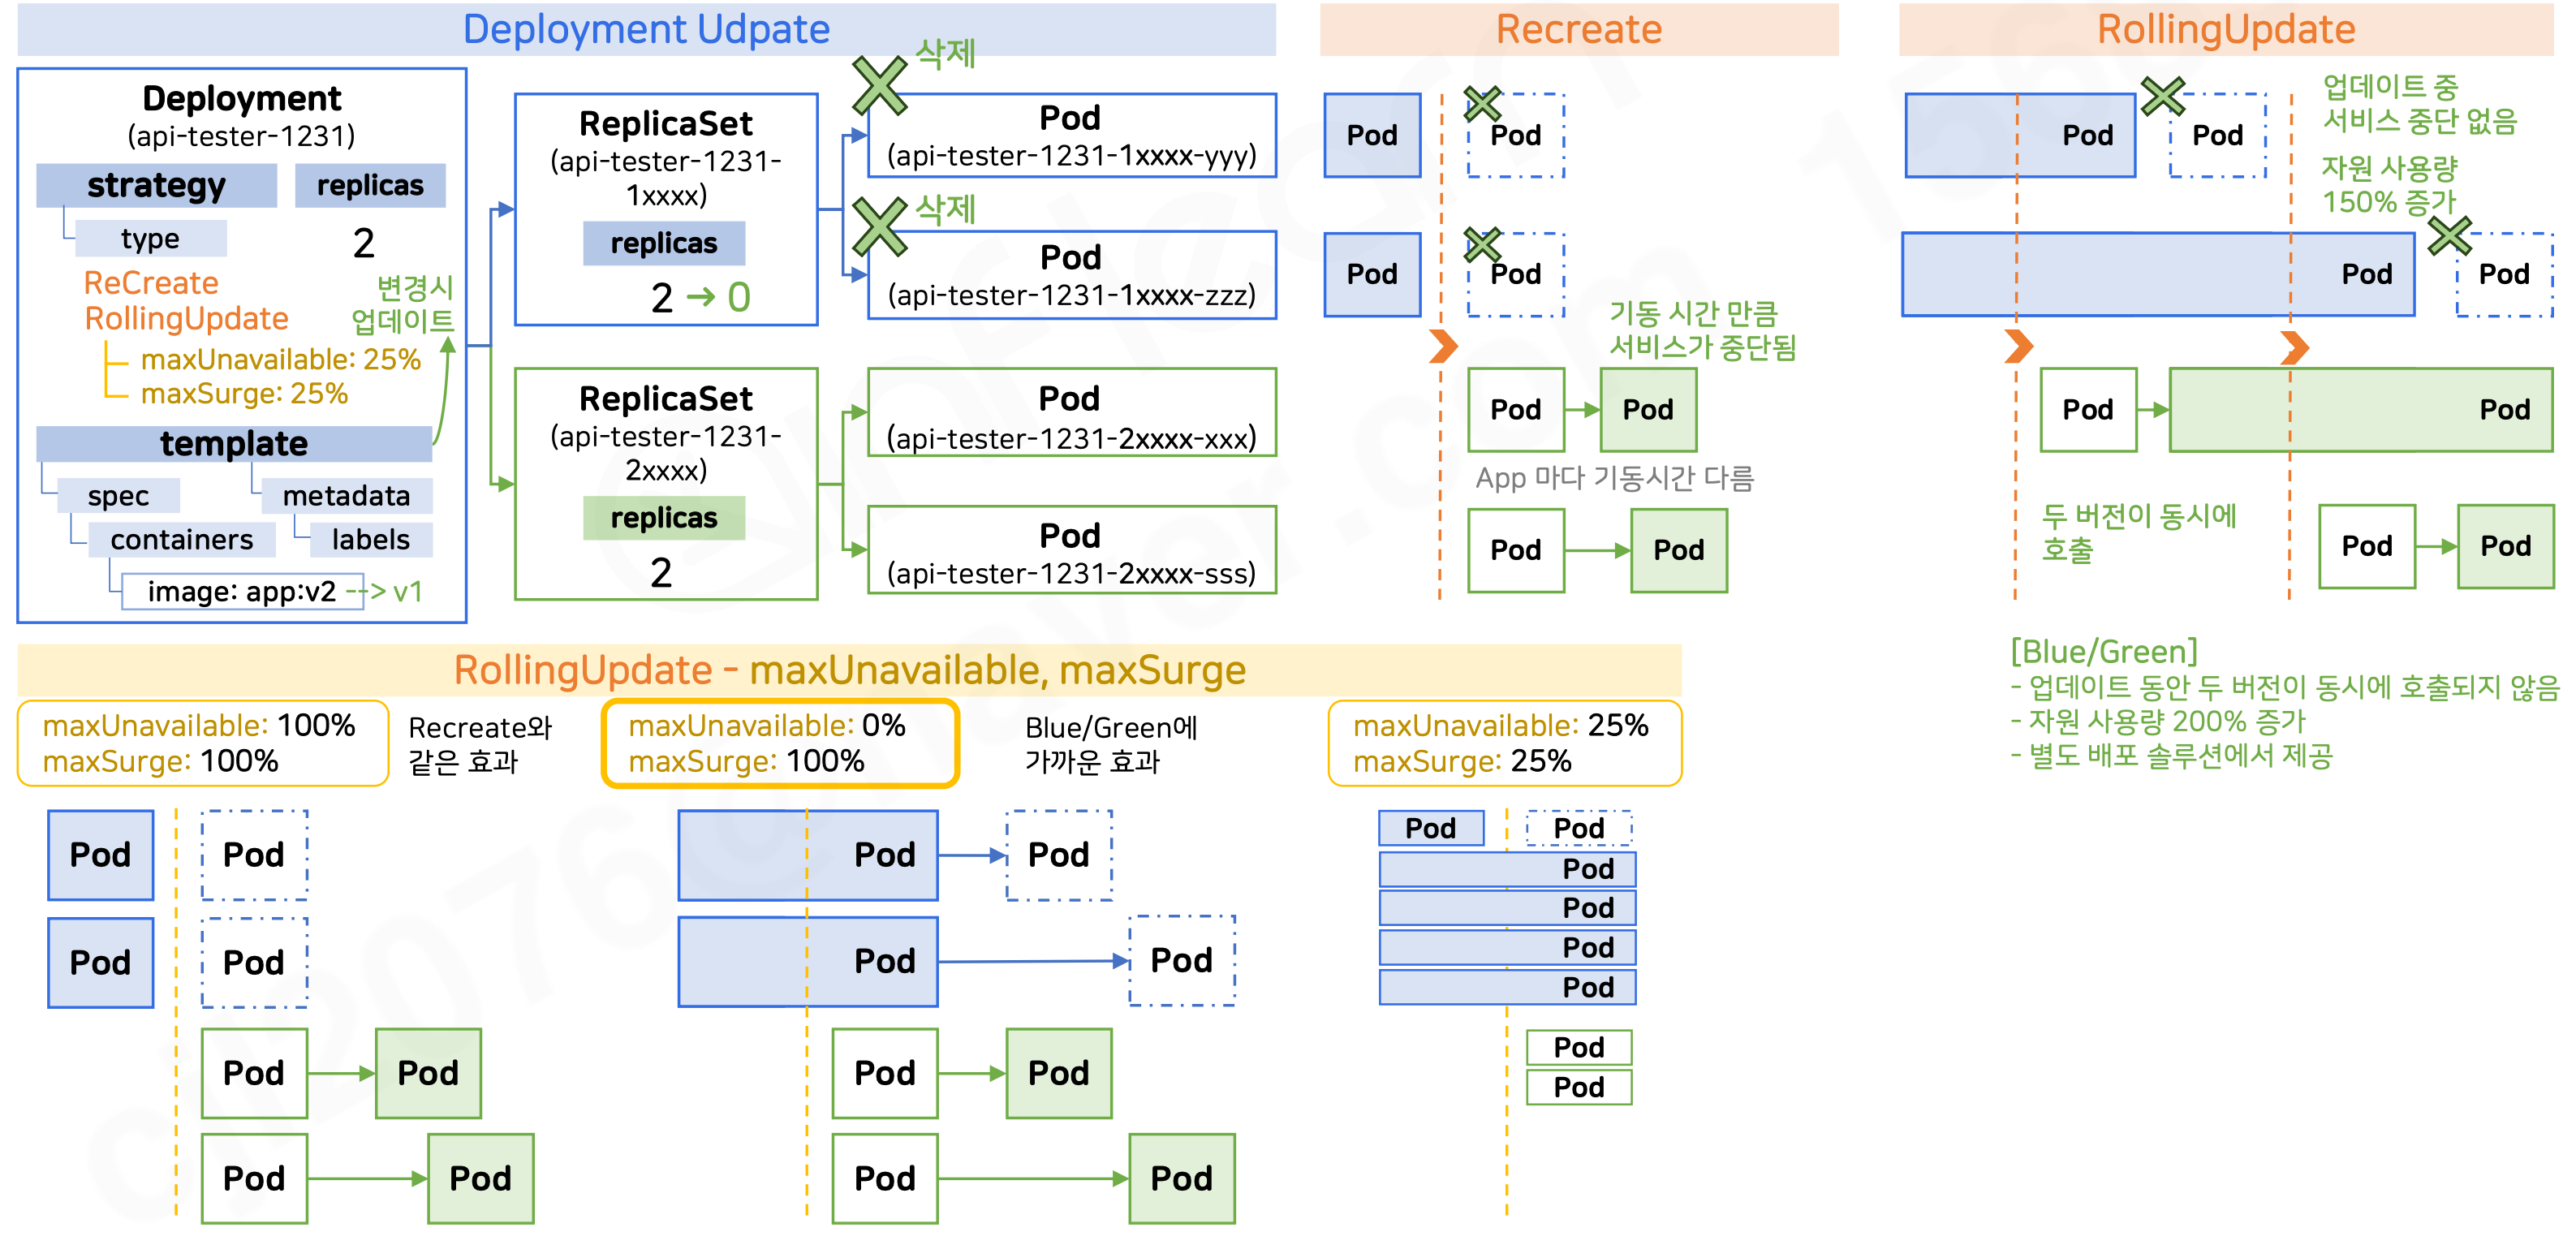
- 파드를 하나하나 생성하기 번거로움 → Deployment로 선언적 관리
안정적인 배포, 스케일링을 위해 보통 Pod를 직접 만들기보다 Deployment를 통해 생성 - 업데이트 전략 (*롤링 업데이트, 롤백), 오토스케일링 등 제공
*서비스 중단 없이 기존 버전의 파드를 새 버전으로 하나씩 순차적으로 교체하는 배포 방식(레플리카셋 교체) - Deployment 적용 시 ReplicaSet을 만들어 내고, ReplicaSet을 통해 Pod를 생성하여 파드 복제본 관리
Deployment를 통해 Replicaset 자원을 버전별로 생성(Revision) -> 롤백 시 유용
Deployment가 복수 개의 ReplicaSet을 통해 Rolling Update 처리
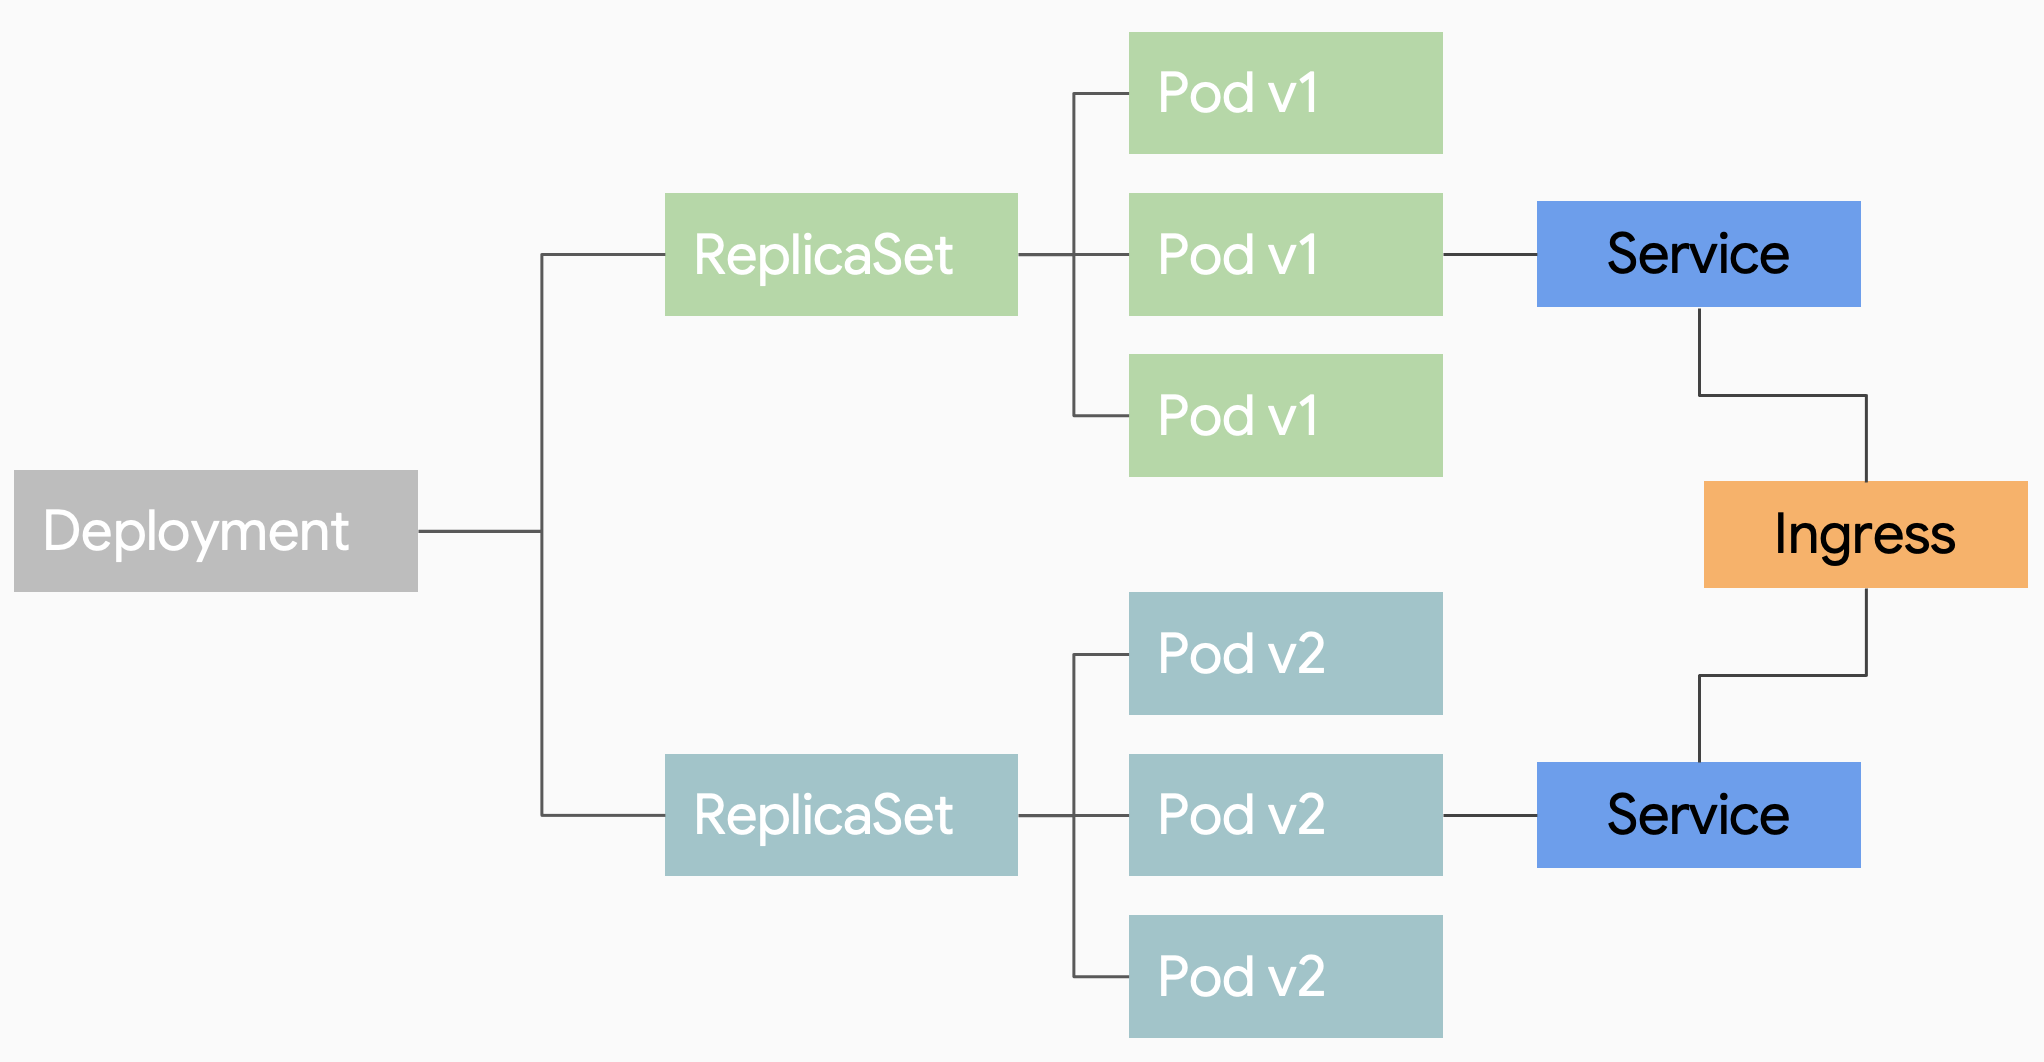
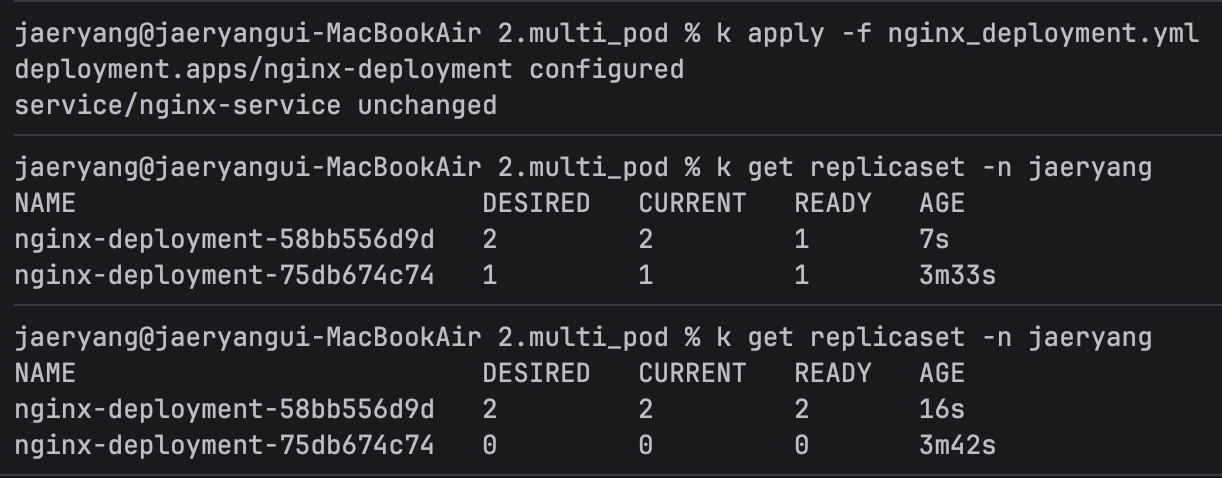
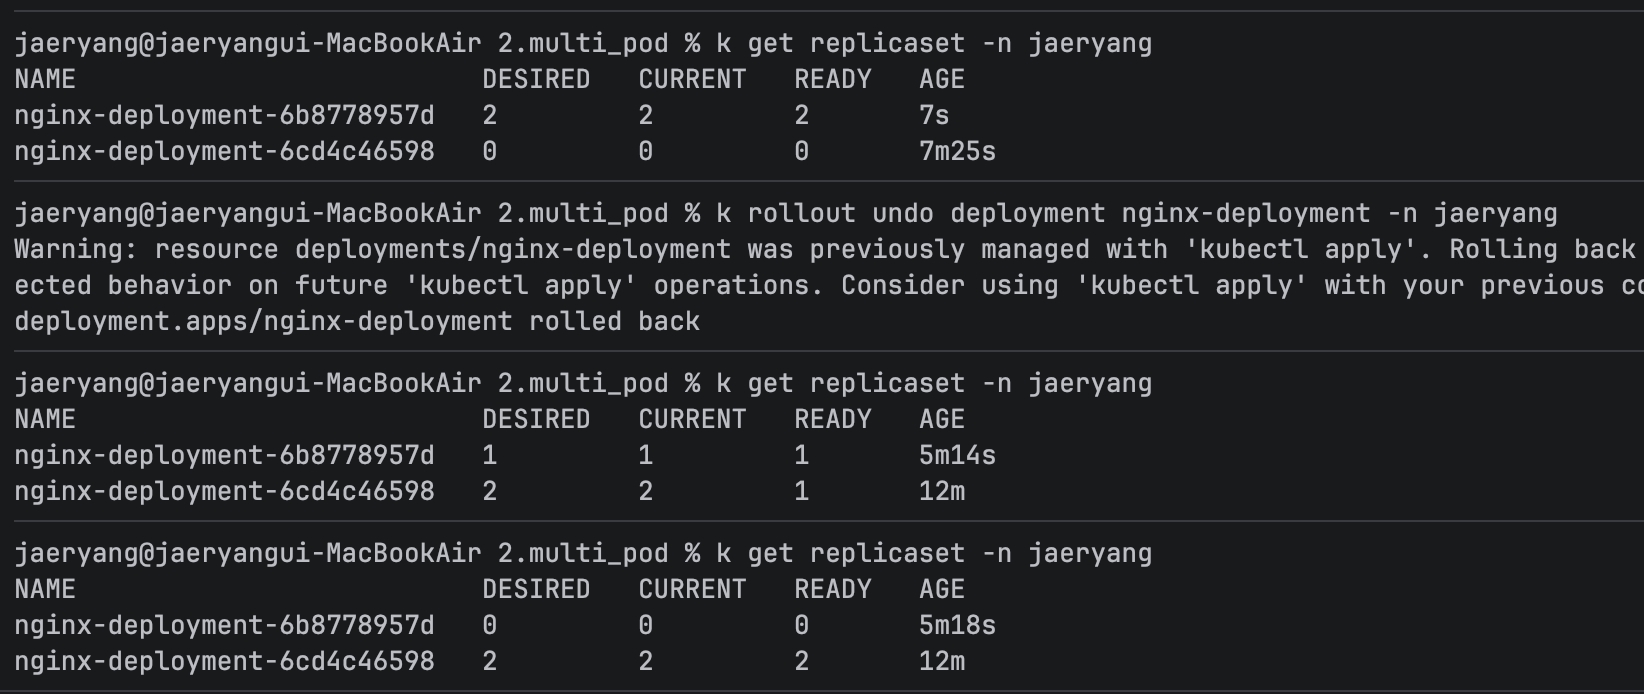
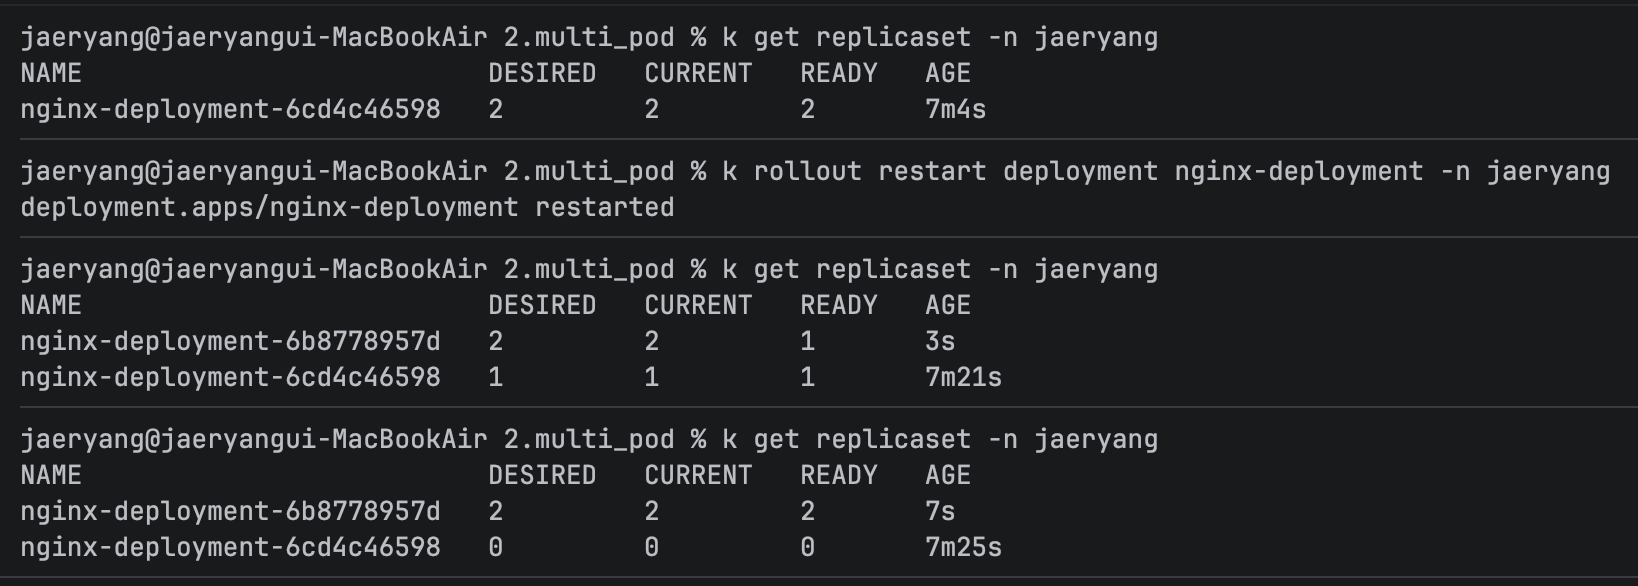
template 하위 내용이 변경되면 업데이트가 시작되면서 새 ReplicaSet이 생성 된다.
업데이트 타입은 2개가 있다.
- 무중단 배포가 중요하지 않다면 ReCreate를 써도 된다.
- RollingUpdate 는 무중단배포가 가능하며, 배포 툴(ArgoCD)을 쓰면 다른 버전이 동시 호출되지 않는 Blue/Green 기능도 쓸 수 있다.
Service
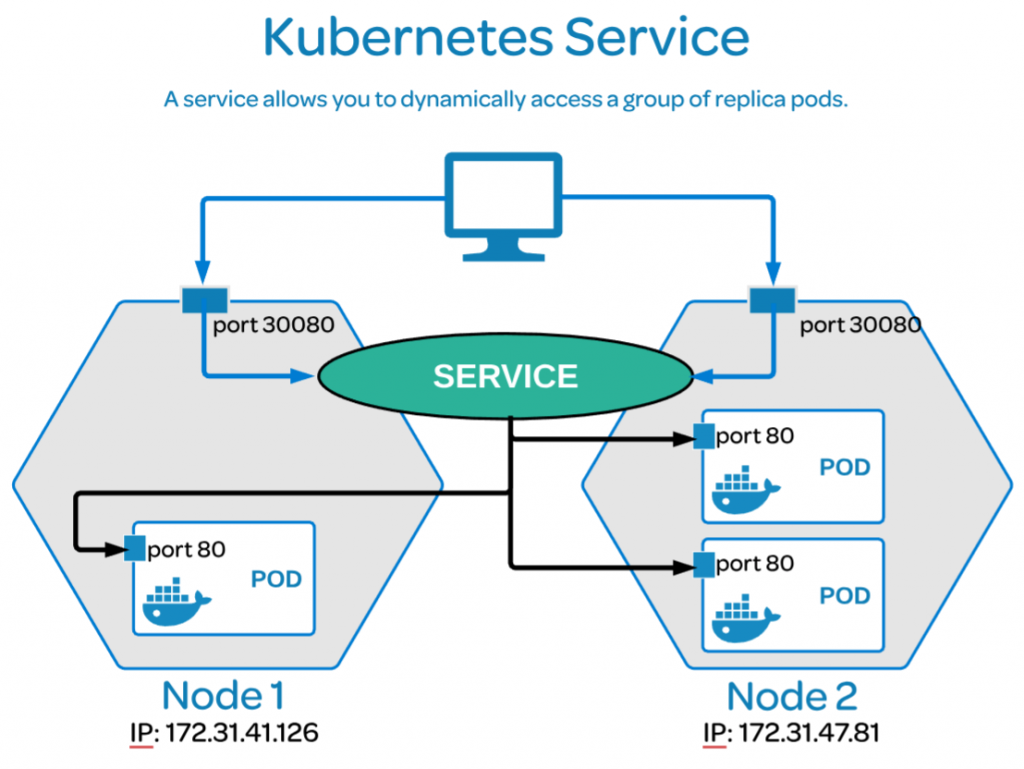
- 외부/내부 접근을 위해 Pod에 네트워크를 붙여주는 역할(L4 로드밸런서) → Deployment 위에 있음
- Pod는 재생성 시 IP가 바뀌므로, Service가 중간에서 고정된 접근 지점 역할
여러 Pod(=Replica들)에 대해 단일 IP/도메인으로 접근 가능하게 해줌 - 여러 Pod들 간의 로드밸런싱 및 페일오버 → 여러 파드에 부하 분산
- 여러 타입이 있으나, 서비스는 보통 내부 요청만 받게 설정함.
보안 및 리소스 절약 차원 (외부에서 직접 요청 받으려면 MSA 구조에서 LB가 각각 필요)
파드끼리 통신할 때 포트번호를 고정하면 안되니까, 서비스에 요청해야 함(서비스 디스커버리)
- ClusterIP: 클러스터 내부 통신
- NodePort: 외부 접근 (포트 노출)
- LoadBalancer: 클라우드 외부 LB 연동
“쿠버네티스에서 어떤 앱을 띄우려면 먼저 Pod에 컨테이너를 실행시킵니다. 하지만 이 Pod는 언제 죽을지 모르고, 개수를 직접 유지하는 것도 번거롭죠. 그래서 등장한 게 Deployment입니다. 이건 Pod가 항상 원하는 개수만큼 유지되게 해주고, 코드 업데이트도 안정적으로 도와줘요. 그런데 Pod들이 계속 바뀌다 보니 IP도 바뀌고, 외부나 내부에서 접근하기 어렵습니다. 그래서 마지막으로 Service를 써서 안정적인 네트워크 접근 지점을 만들어주는 거예요.”
서비스 역할 정리
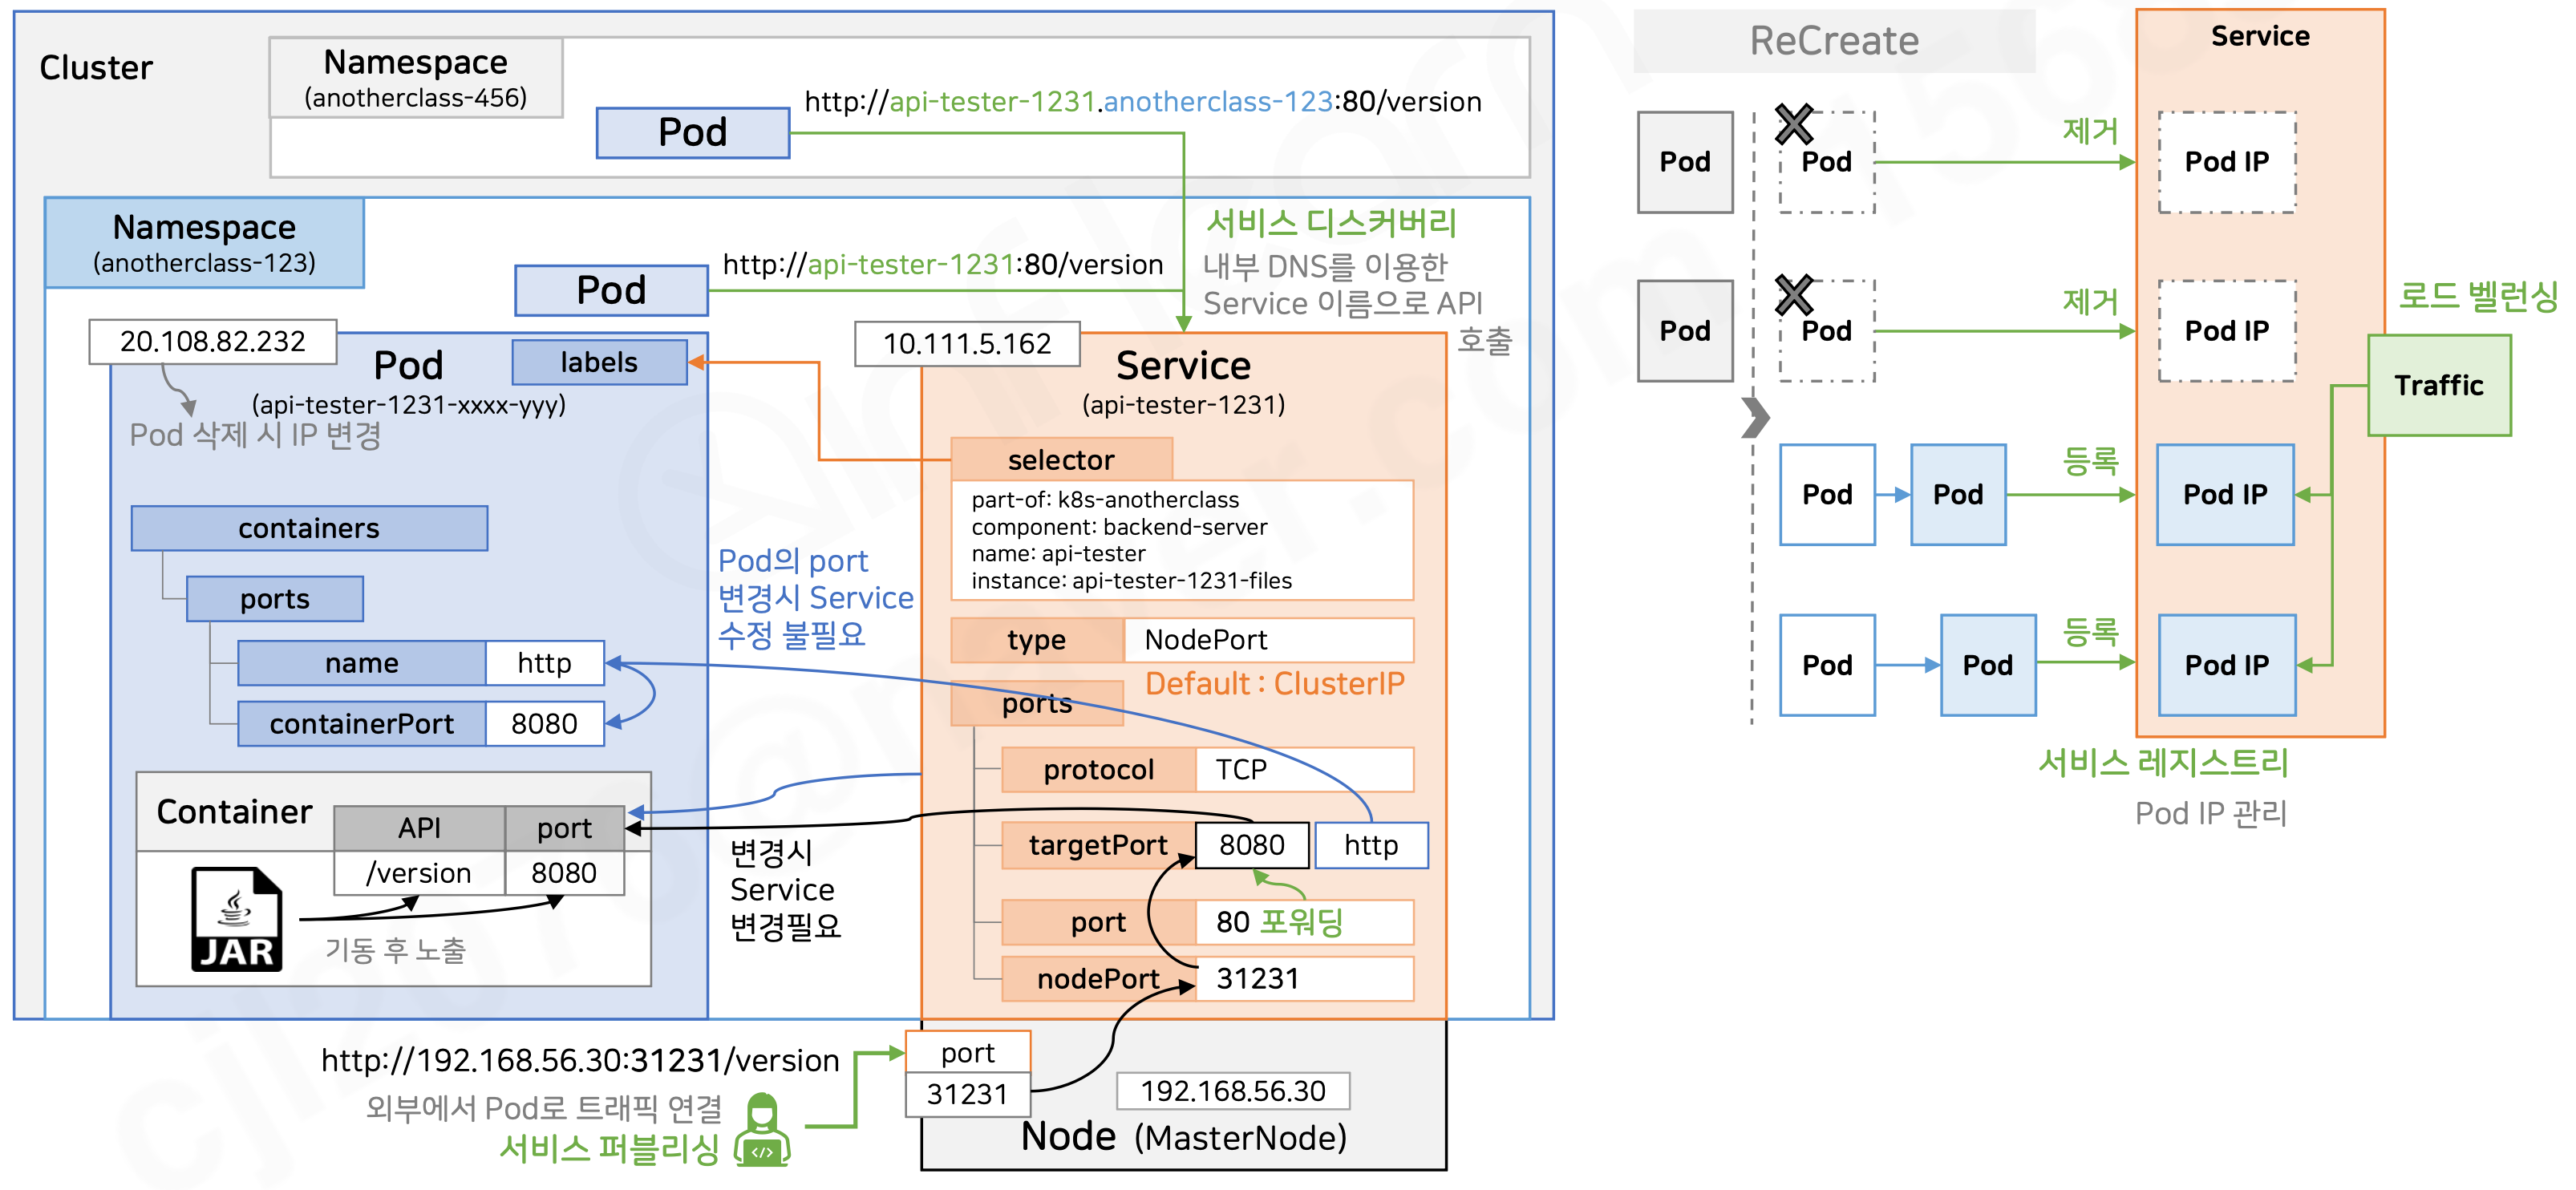
- 서비스 퍼블리싱: 외부에서 Pod로 트래픽 연결
- 서비스 디스커버리: 서비스 이름을 자동으로 쿠버네티스 내부 DNS에 등록하여, 서비스 이름으로 API 호출 가능
- 서비스 레지스트리: 파드에 서비스만 연결해두면 IP를 등록해주므로 파드가 새로 만들어져도 호출에 문제x
- 로드밸런싱: 트래픽 분산
Ingress
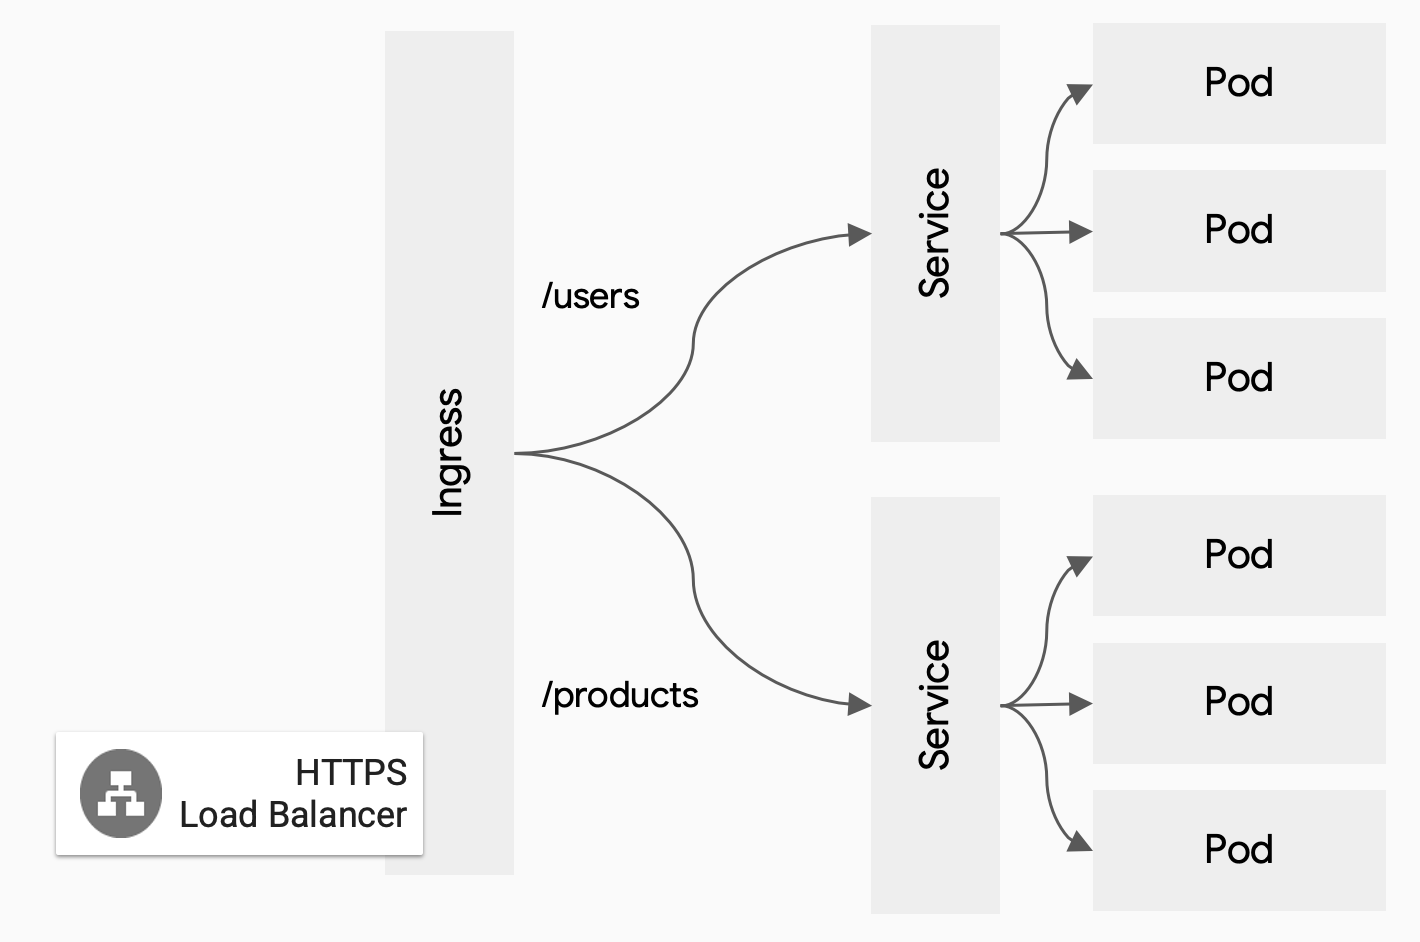
- 클러스터 외부에서 내부의 service로 라우팅 규칙을 정의
prefix 단위로 service 마다 라우팅이 될 수 있도록 규칙 설정 가능 - Ingress가 필요한 이유 — "하나의 진입점"으로 통합
- Service(LoadBalancer 타입)로 외부 노출하면 Service마다 클라우드 로드밸런서가 하나씩 새로 생김
-> MSA에서 서비스가 많을 경우 비용이 너무 많이 발생함.
- 또한 Service는 L4 스위치로 IP:Port만 볼 뿐 도메인/URL 경로를 읽을 수 없음
> 로드밸런서(또는 진입점) 하나만 만들어두고, 그 뒤에서 url을 보고 알맞은 Service로 나눠주는 L7 안내데스크 역할
Ingress Controller
- Ingress는 규칙 정보 정의, Ingress Controller는 실질적인 라우팅을 수행
Ingress Controller가 ingress 리소스를 해석하고 실제로 service로의 라우팅 수행 - Ingress 리소스에 도메인(host)을 지정하면, Ingress Controller는 도메인별로 적절한 Ingress를 찾는다
도메인이 다른 Ingress가 여러 개 있어도 Ingress Controller는 하나만 있어도 되고, Controller가 여러 Ingress 리소스를 참조하여 라우팅을 수행
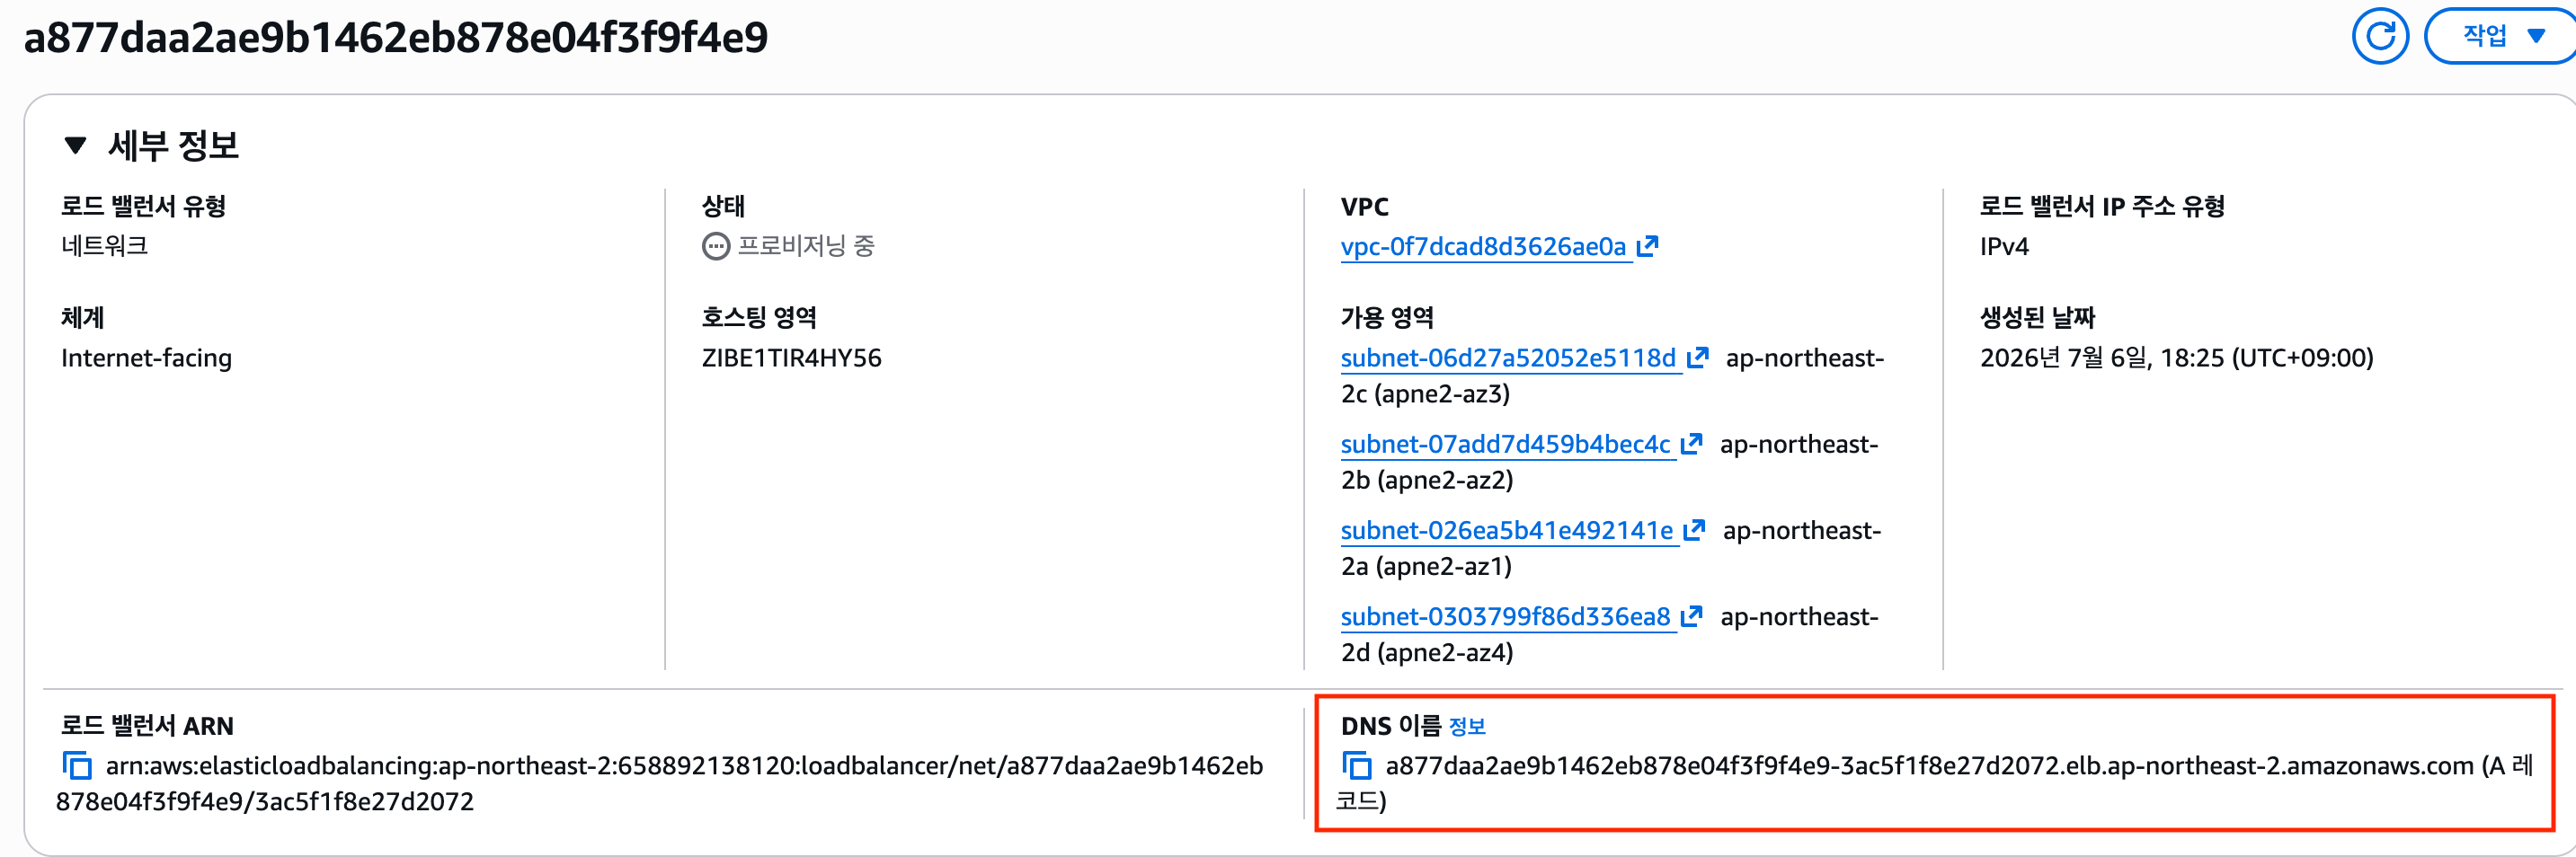
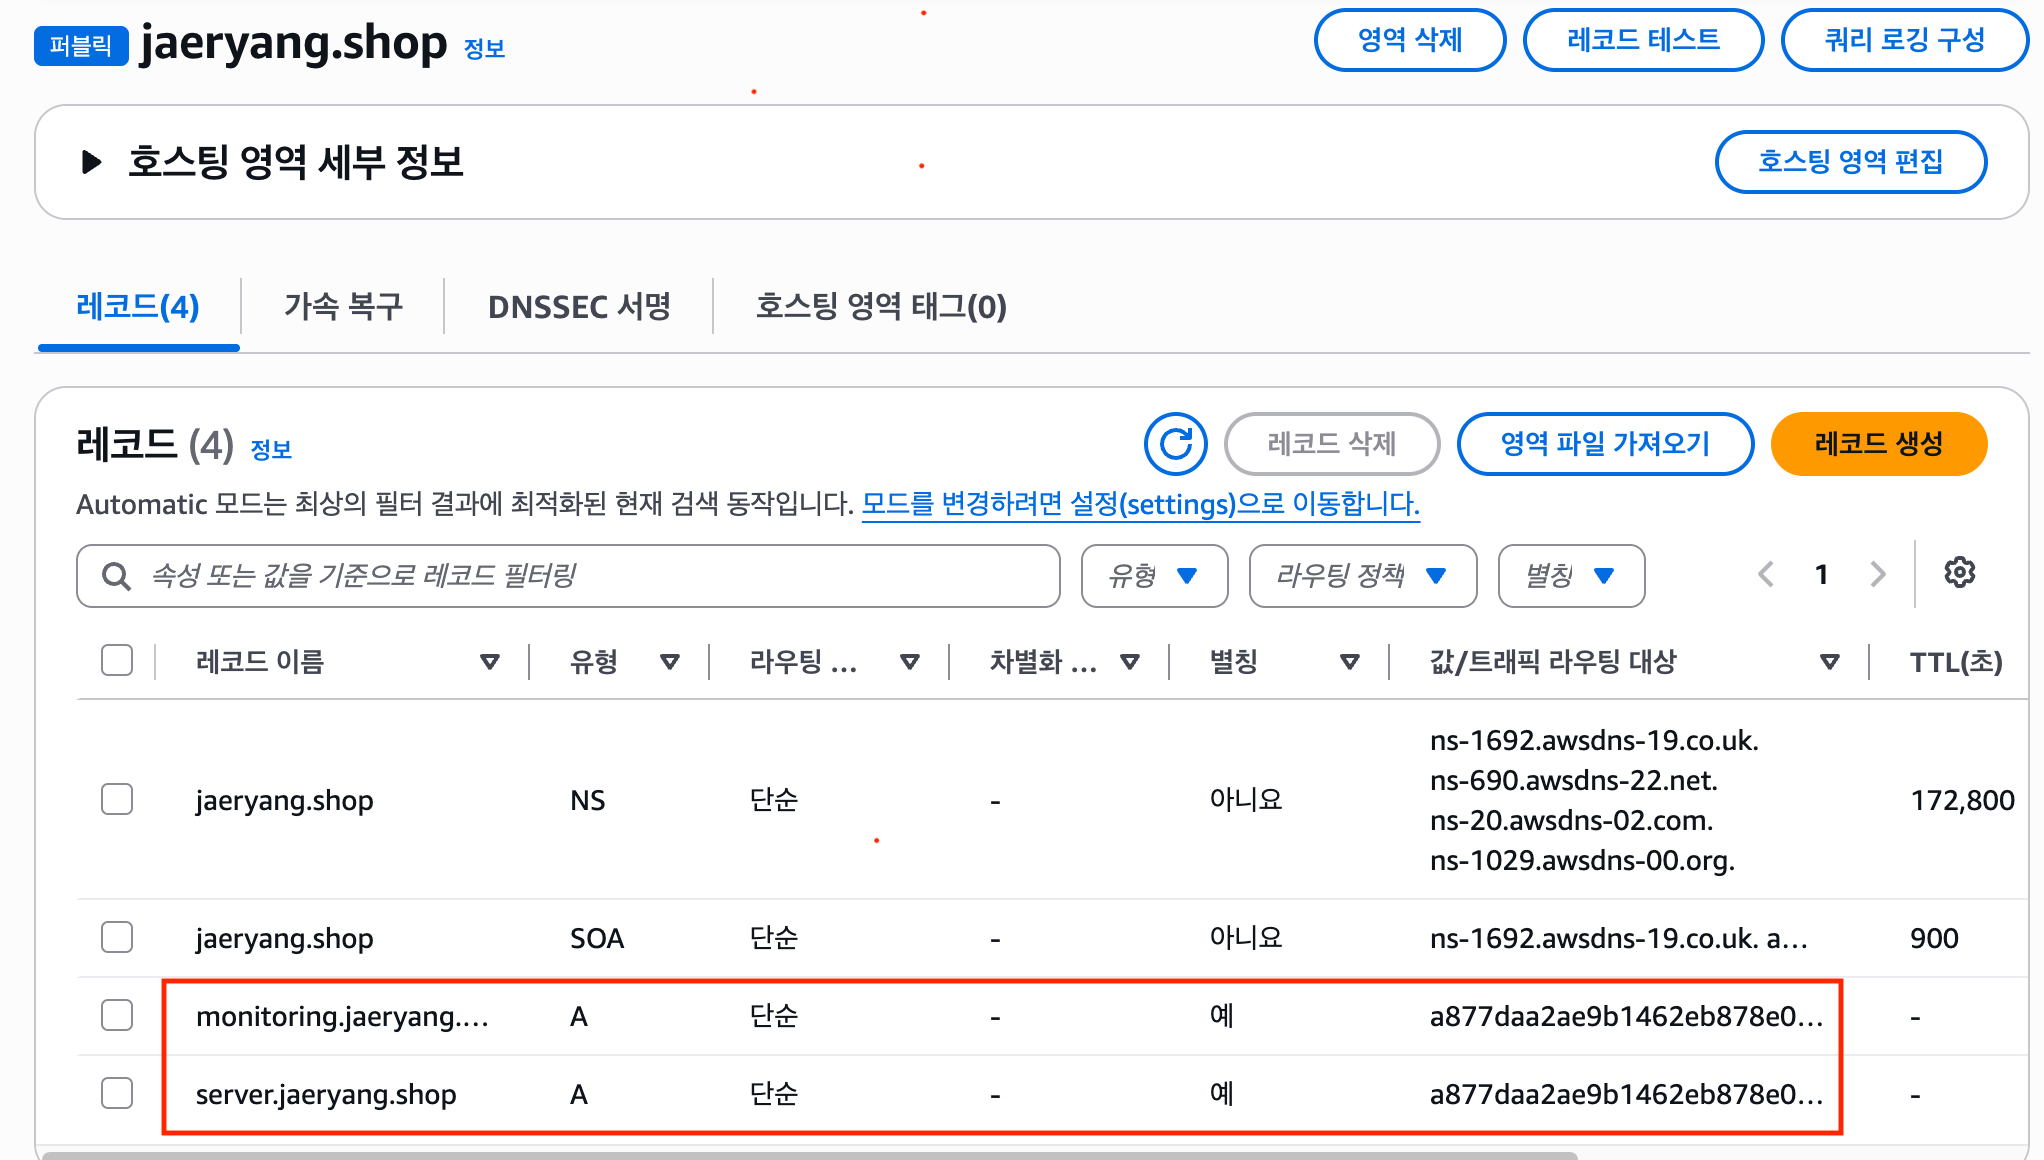
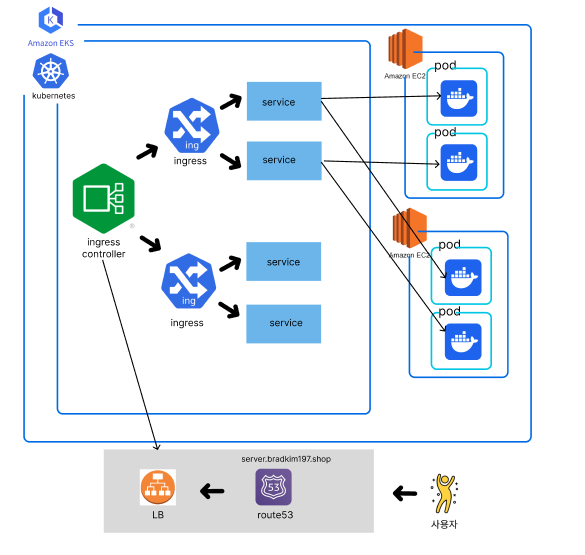
- Route53 → DNS 안내소 (도메인 → LB IP/주소 매핑)
- LB (로드밸런서) → 실제 트래픽을 받는 물리적 입구 (클라우드가 제공)
- Ingress Controller → LB 뒤에서 도메인/경로를 읽고 분기하는 "일꾼" (nginx 등)
- Ingress → Ingress Controller에게 "이렇게 분기해라"라고 주는 규칙(YAML)
- Service → 각 분기된 트래픽을 실제 Pod로 마지막 전달
전체 흐름
1. 사용자가 monitoring.jaeryang.shop 접속
↓
2. [Route53] DNS 조회
"monitoring.jaeryang.shop이 어디야?"
→ Alias 레코드로 LB를 가리키고 있음
→ LB의 주소를 알려줌
↓
3. [LB] 실제 요청이 로드밸런서로 도착
(이 LB는 클러스터 안의 Ingress Controller로 트래픽을 흘려보내는 창구 역할)
↓
4. [Ingress Controller] 요청의 Host 헤더 확인
"Host: monitoring.jaeryang.shop"
→ Ingress 오브젝트에 정의된 규칙을 보고 판단
↓
5. [Ingress] 규칙 문서 확인
"monitoring.jaeryang.shop → monitoring-service로 보내라"
↓
6. [Service: monitoring-service]
ClusterIP로 존재, 뒤에 연결된 Pod들 중 하나로 트래픽 전달
↓
7. [Pod] 실제 모니터링 애플리케이션(예: Grafana)이 응답
# ingress-controller 설치 명령어
# kubectl apply -f https://raw.githubusercontent.com/kubernetes/ingress-nginx/controller-v1.8.1/deploy/static/provider/aws/deploy.yaml
# aws lb -> ingress controller pod -> ingress -> service로의 라우팅

apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: nginx-ingress1
  namespace: jaeryang
  annotations:
  # 여기서 "nginx"로 지정한 것은 이 Ingress가 NGINX 기반 Ingress Controller에 의해 처리된다는 의미
    kubernetes.io/ingress.class: nginx
    nginx.ingress.kubernetes.io/rewrite-target: /$1 #첫번쨰 prefix제거 (server.jaeryang.shop/service1/home -> server.jaeryang.shop/home)

spec:
  rules:
  - host: server.jaeryang.shop  # 설정하려는 도메인 이름.
    http:
      paths:
      # - path: /
      - path: /service1/ #service1으로 시작하는 모든 url요청을 nginx-service1로 라우팅한다는 정규표현식
        pathType: Prefix
        backend:
          service:
            name: nginx-service
            port:
              number: 80
      - path: /service2/ #service2으로 시작하는 모든 url요청을 nginx-service2로 라우팅한다는 정규표현식
        pathType: Prefix
        backend:
          service:
            name: nginx-service2
            port:
              number: 80
Gateway
Ingress 한계: 표준이 아니라 컨트롤러 종속
Ingress는 라우팅 규칙(host/path)만 표현할 수 있는 단일 리소스에 어노테이션을 욱여넣는 구조
"외부 → 클러스터 진입" 딱 한 가지 유스케이스만 상정하고 설계되어, 전부 컨트롤러별 annotations로 우회 구현
Gateway API는 이를 역할별로 분리된 리소스(GatewayClass/Gateway/HTTPRoute 등)로 재설계해 표준화·확장성·멀티테넌시를 해결한 후속 규격.
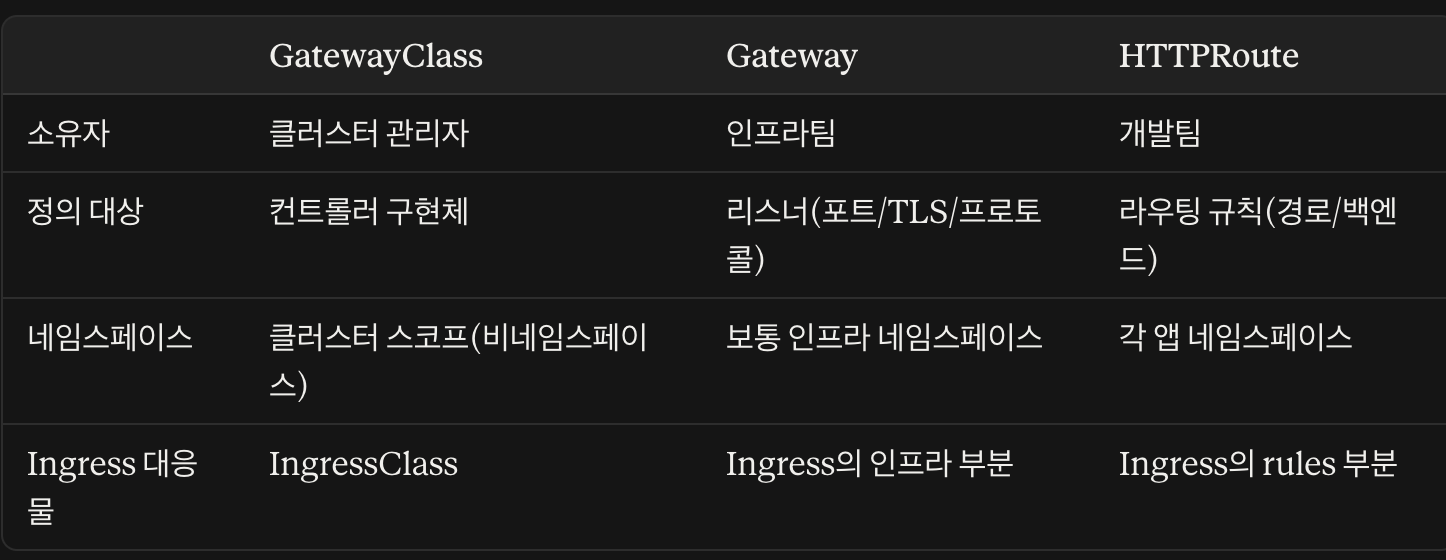
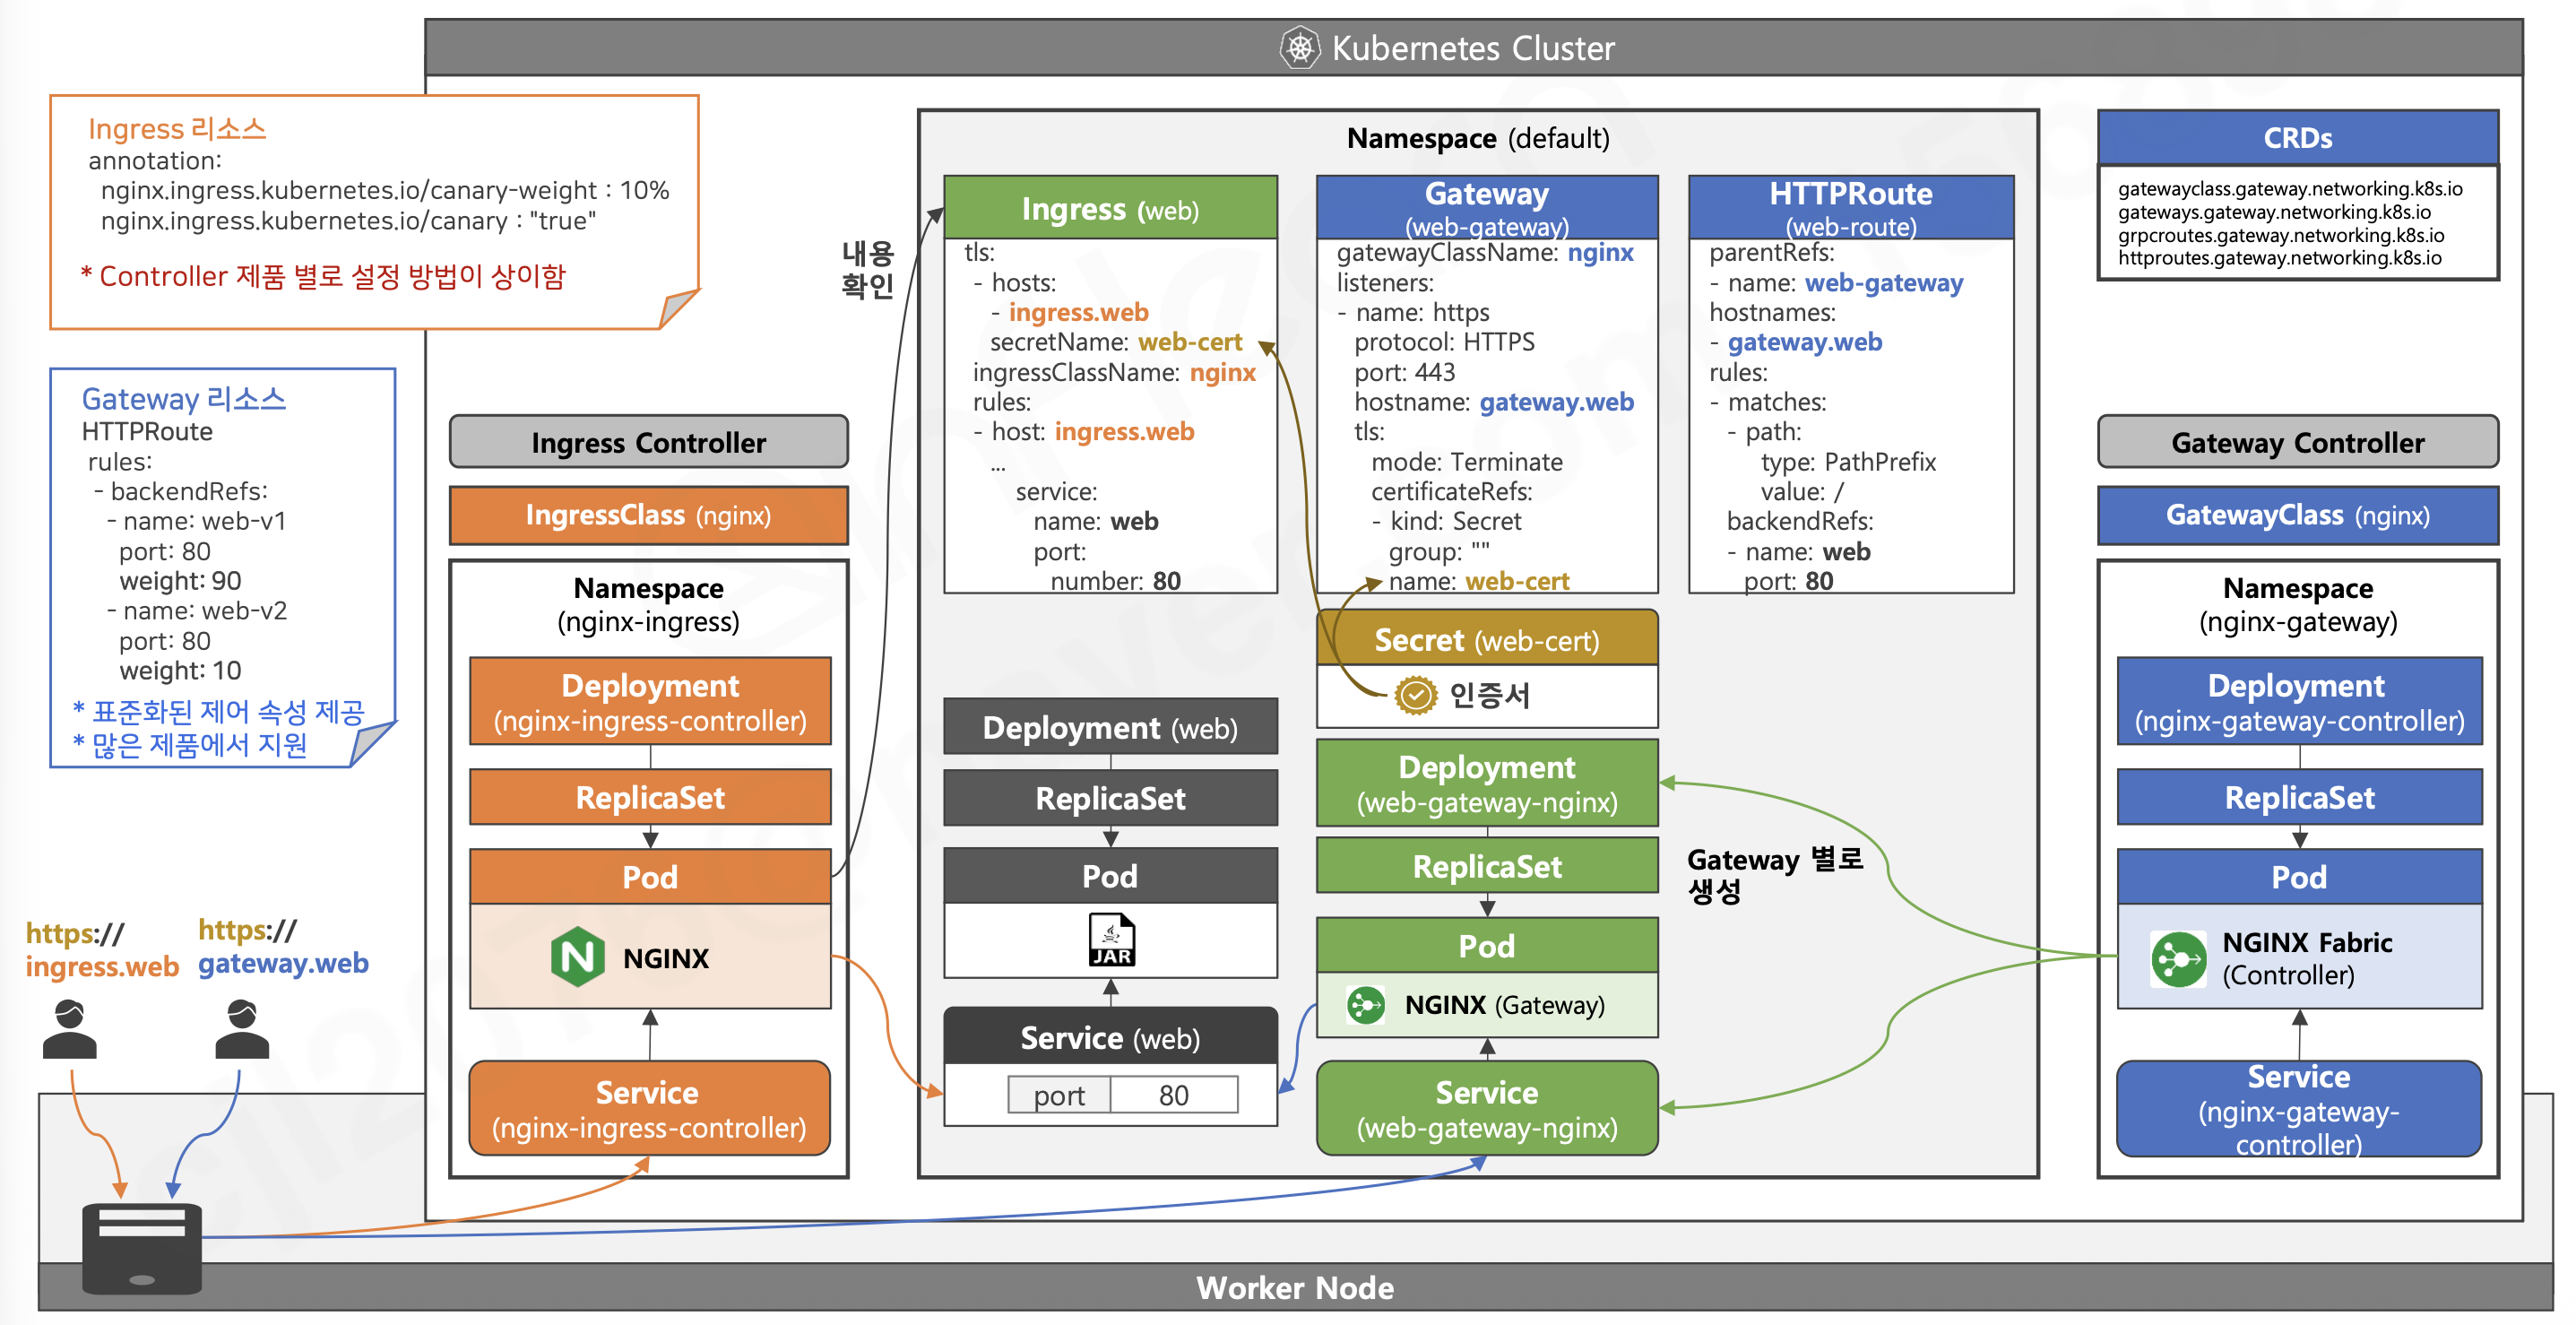
ex) 기존 Ingress에서 annotation으로 처리하던 카나리(nginx.ingress.kubernetes.io/canary-weight)를 gateway로 전환
-> backendRefs[].weight라는 표준 필드로 승격
# 1) 플랫폼팀이 만드는 Gateway (진입점 자체)
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: shared-gateway
  namespace: infra
spec:
  gatewayClassName: nginx   # 실제 구현체 지정
  listeners:
    - name: http
      protocol: HTTP
      port: 80
      hostname: "*.example.com"
---
# 2) 개발팀이 만드는 HTTPRoute (라우팅 규칙)
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: my-app-route
  namespace: dev
spec:
  parentRefs:
    - name: shared-gateway
      namespace: infra
  hostnames:
    - "app.example.com"
  rules:
    - matches:
        - path:
            type: PathPrefix
            value: /api
      backendRefs:
        - name: my-app-service
          port: 8080
          weight: 90        # 카나리 배포용 트래픽 분산
        - name: my-app-service-canary
          port: 8080
          weight: 10
NetworkPolicy
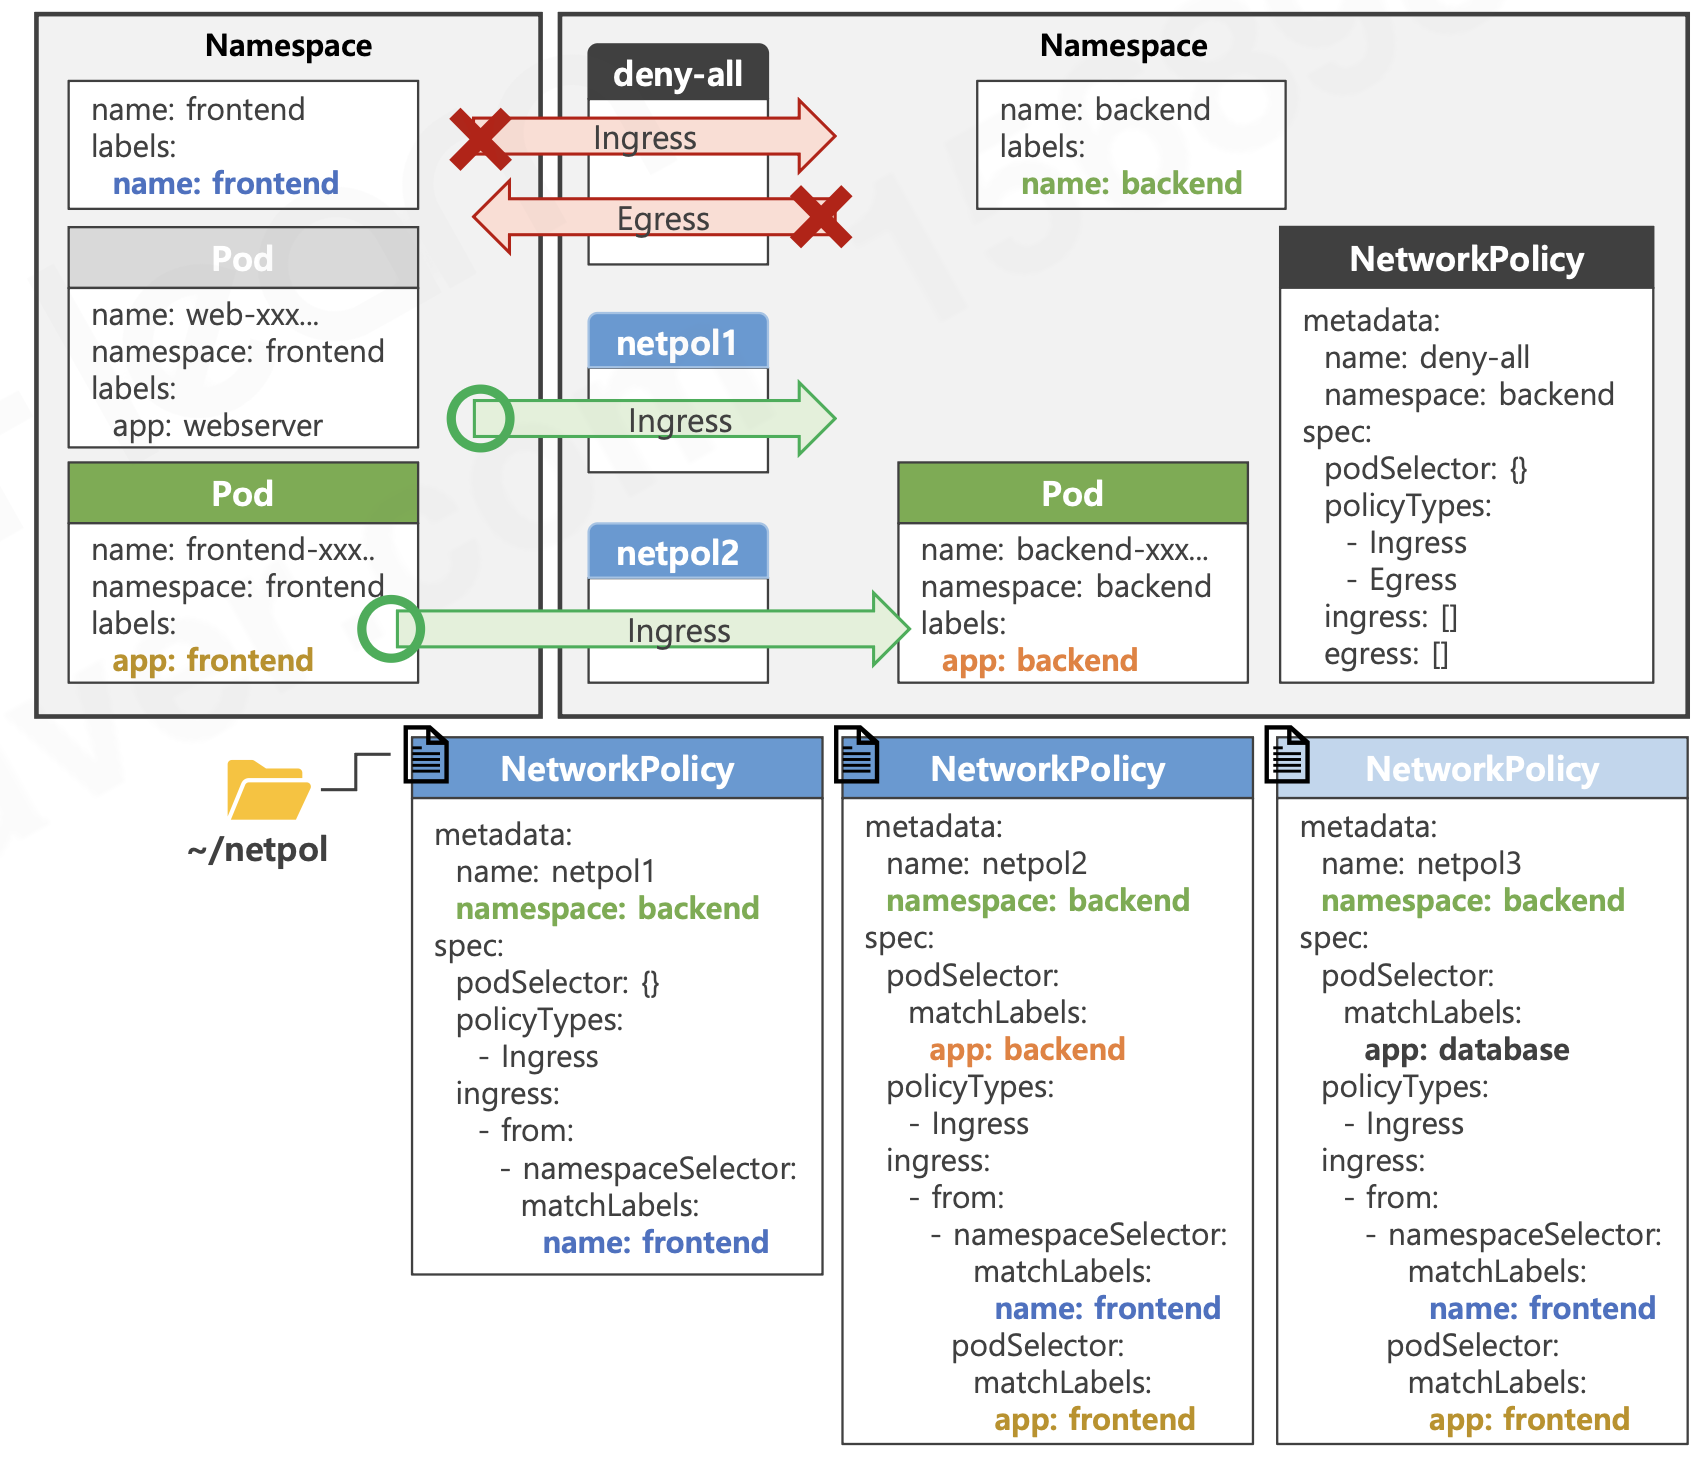
쿠버네티스 파드 간 또는 네임스페이스 간 통신을 제어하는 보안 리소스
네트워크 정책은 파드에 대한 인그레스(수신) 및 이그레스(송신) 트래픽을 규칙에 따라 허용하거나 차단하여 통신을 제어한다.
백엔드 기준에서, networkPolicy를 만들어 서로 다른 네임스페이스(frontend, backend)에서 통신할 수 있게끔 할 수 있다.
엄격하게 제한하려면 namespace 전체를 여는게 아니라 pod 기준으로 설정한다.
ConfigMap / Secret
- Secret은 비밀번호, 인증서 같은 민감 정보를 저장
- ConfigMap은 설정파일처럼 Key-Value로 데이터를 관리(민감하지 않은 데이터)
- 환경변수 주입 방식과 설정 파일 마운트 방식이 있다.
StatefulSet
StatefulSet은 각 Pod에 고유한 ID와 안정적인 네트워크, 그리고 영구 스토리지를 할당하여
데이터베이스 같은 상태 저장 애플리케이션에 적합한 컨트롤러이다. (Deployment는 스케일링 시 볼륨 공유에 문제가 생길 수 있다)
참고 자료 & 이미지 출처
Kubernetes Infrastructure Engineer 과정
EKS를 활용한 Spring 운영서버 배포 (feat. devops의 모든 것)
'Infra > Kubernetes' 카테고리의 다른 글
| Argo CD, 프로메테우스/그라파나 (0) | 2026.07.17 |
|---|---|
| Auto Scale (Pod/Node) (0) | 2026.07.17 |
| EKS를 활용한 Spring 운영 서버 배포(Monolithic) (0) | 2026.07.03 |
| AWS EKS를 활용해 서버 배포하기 (0) | 2026.02.04 |
| AWS EC2에서 쿠버네티스를 활용해 서버 배포하기 (0) | 2026.02.02 |