- 분류 전체보기 (221)

| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- Secret
- JPA
- Spring Container
- kafka
- k8s
- CORS
- Web
- DI
- Iam
- argocd
- 쿠버네티스
- Helm
- dockerhub
- Spring Data JPA
- securitycontextholderfilter
- AWS
- 컨테이너
- MSA
- JdbcTemplate
- JWT
- mybatis
- 스프링 부트
- cicd
- docker
- 도메인
- redis
- Spring
- @Transactional
- JPQL
- 페이징
- Today
- Total
look-forest
Auto Scale (Pod/Node) 본문
Auto Scale
Scale Up / Out
스케일링에는 up, out 유형이 있다. up은 서버 스펙을 늘리는 것이고, out은 서버 대수를 늘리는 것이다.
보통 운영 중인 서버 스펙을 늘리는 것은 쉽지않고, 비용도 산술적이 아니라 기하적으로 증가한다.
따라서 실시간성, 비용 때문에 오토스케일링한다고 하면 보통 스케일 아웃이다.
스케일 아웃에는 pod 오토스케일과 인스턴스 오토스케일이 있다.
파드 자동확장을 하다가 더 늘릴 수 없으면 인스턴스 자동확장을 진행한다. 인스턴스 자동확장이 물리적인 서버를 늘리는것이라 더 어렵다.
Pod Auto Scale
HPA
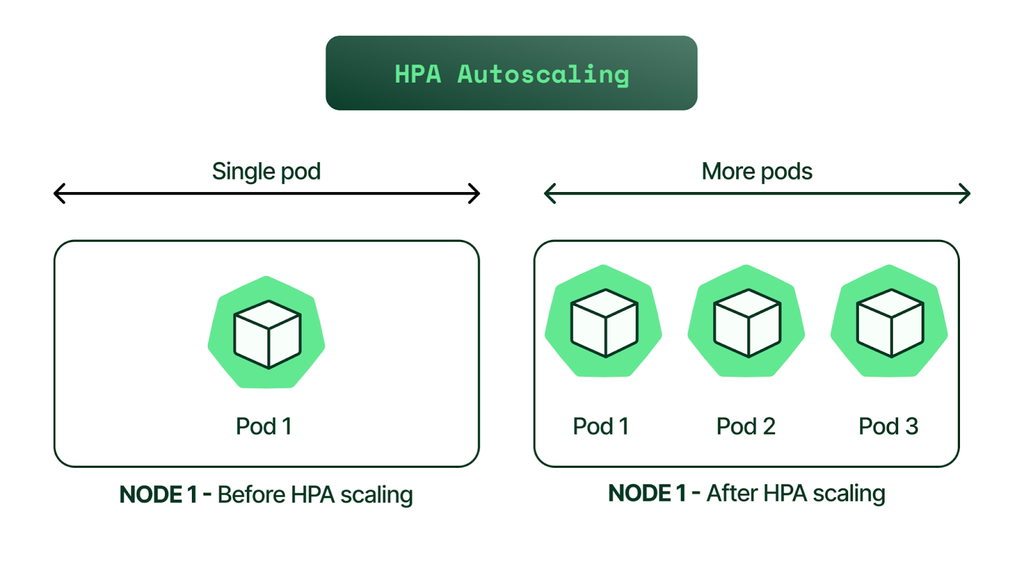
Deployment의 자동 확장(autoscaling)을 설정하려면 Horizontal Pod Autoscaler (HPA)를 사용한다.
HPA는 CPU 사용량이나 사용자 정의 파라미터에 기반하여 파드의 수를 자동으로 조정한다.
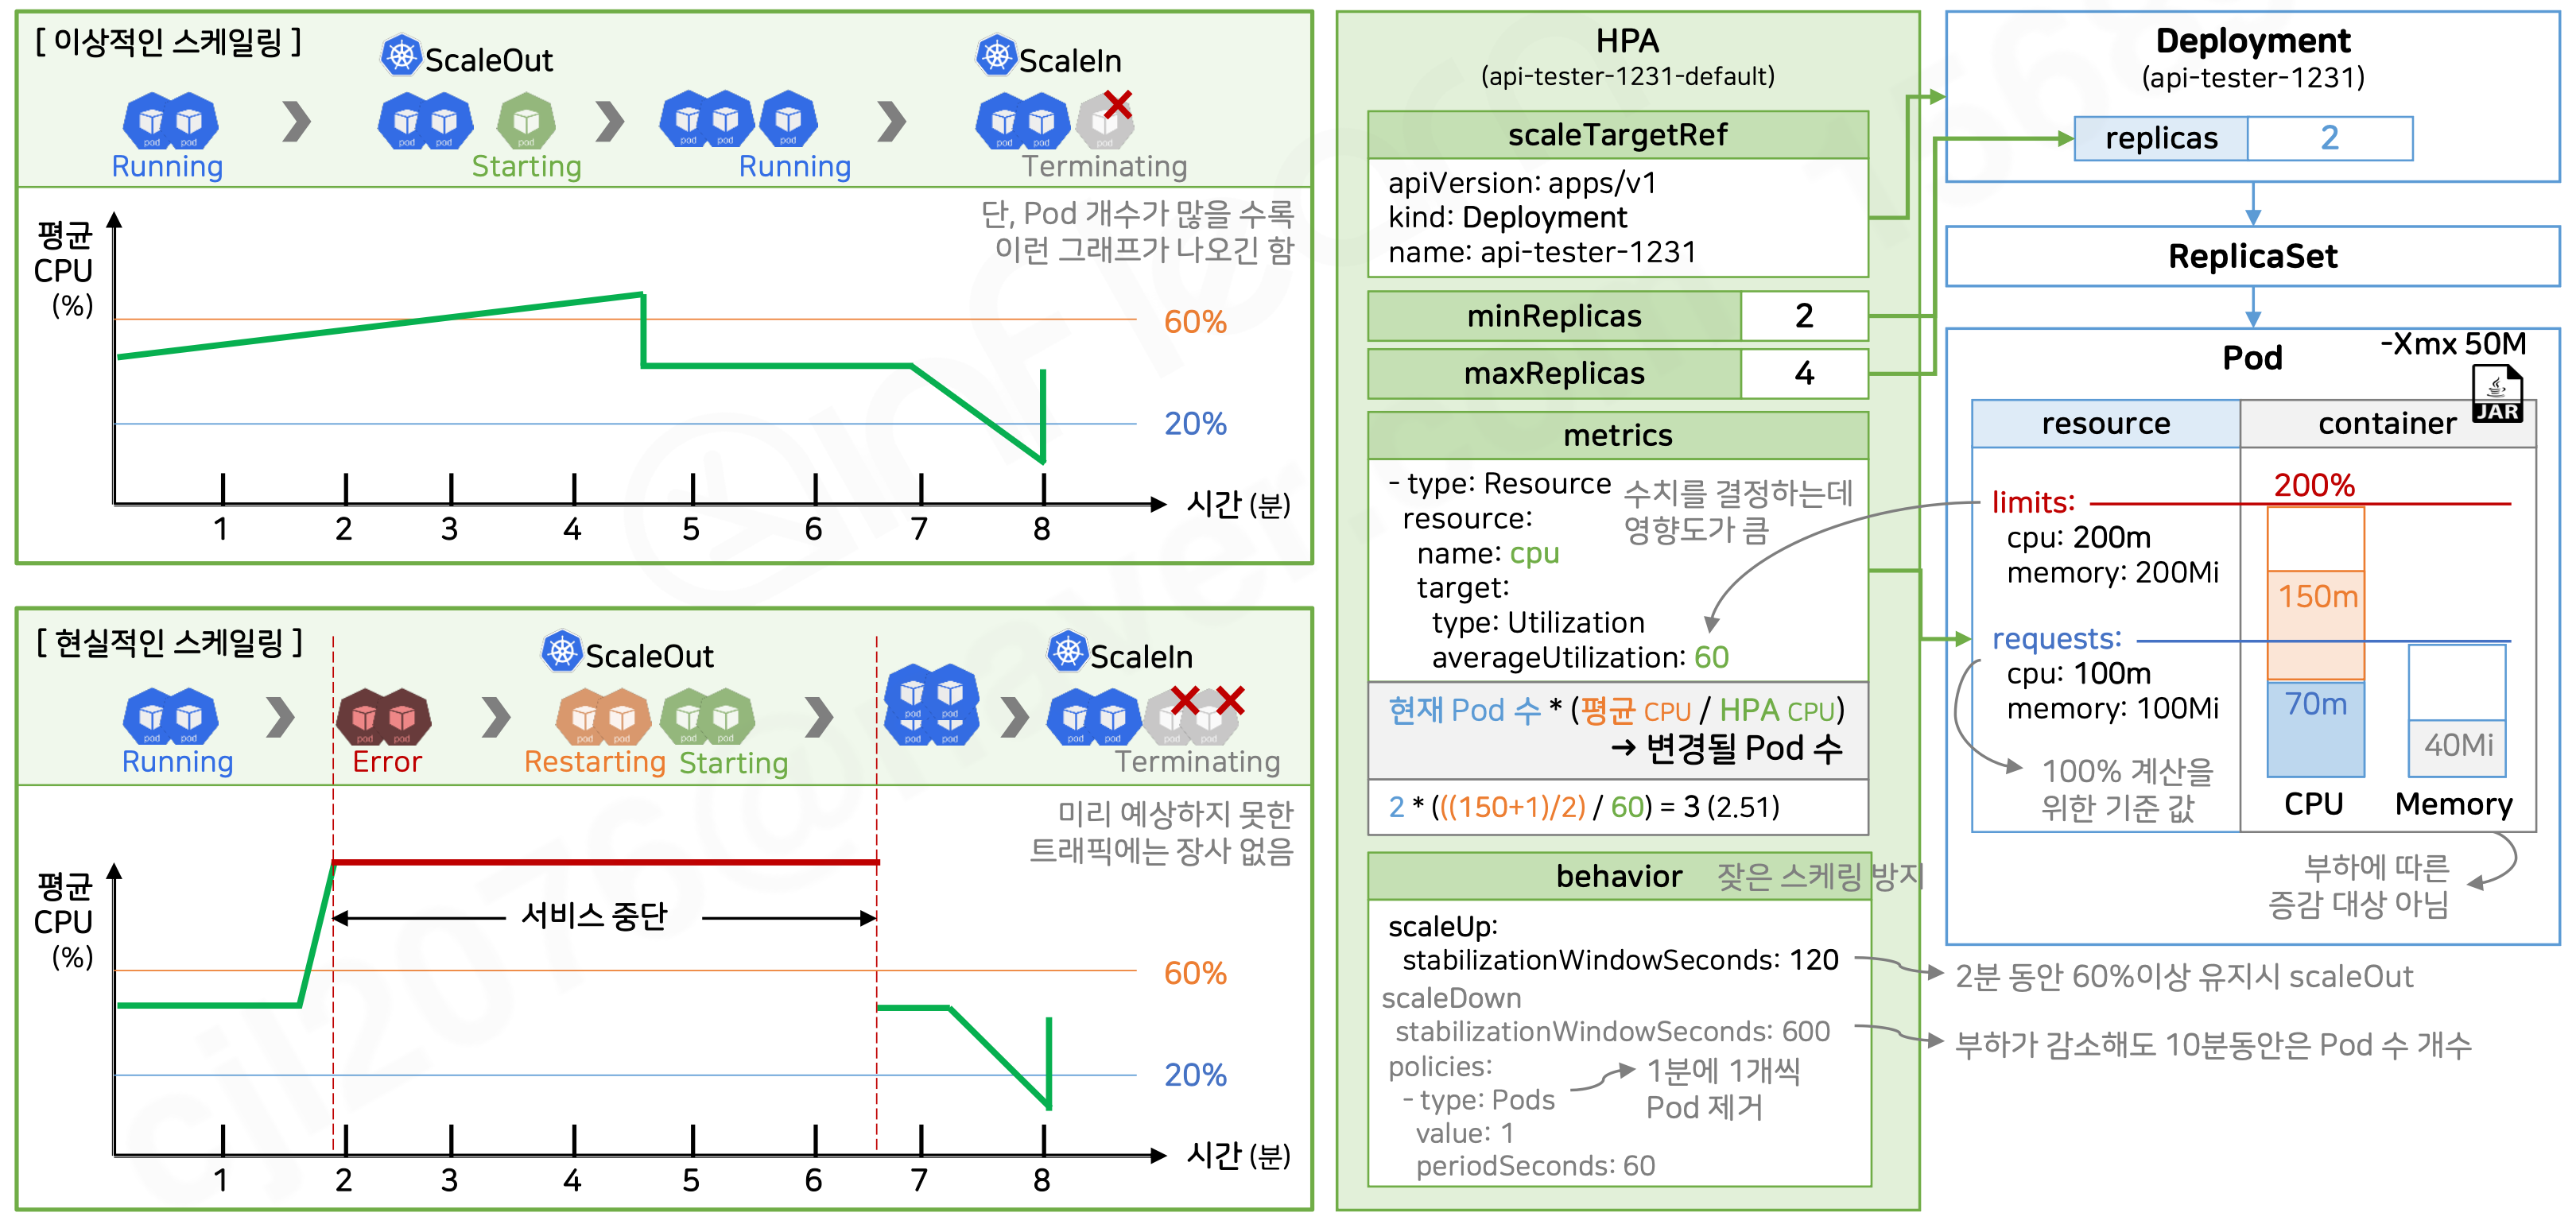
HPA의 이상과 현실
메모리는 임계치가 되면 GC가 일어나기 때문에, 부하에 따른 증감 대상이 아니라 메모리 옵션은 사실 상 거의 쓸일 없고 CPU만 본다.
사실 CPU만 가지고 부하를 판단할 수도 없다. CPU는 여유있는데 DB 커네션이 부족해서 파드를 늘려야 할 수도 있기 때문이다.
또한 미리 대비하지 못한 트래픽에는 장사없다. 자동화는 보조적인 역할일 뿐이다. 갑자기 트래픽이 급증하면 서비스 중단이 있을 수 있다.
적용 절차
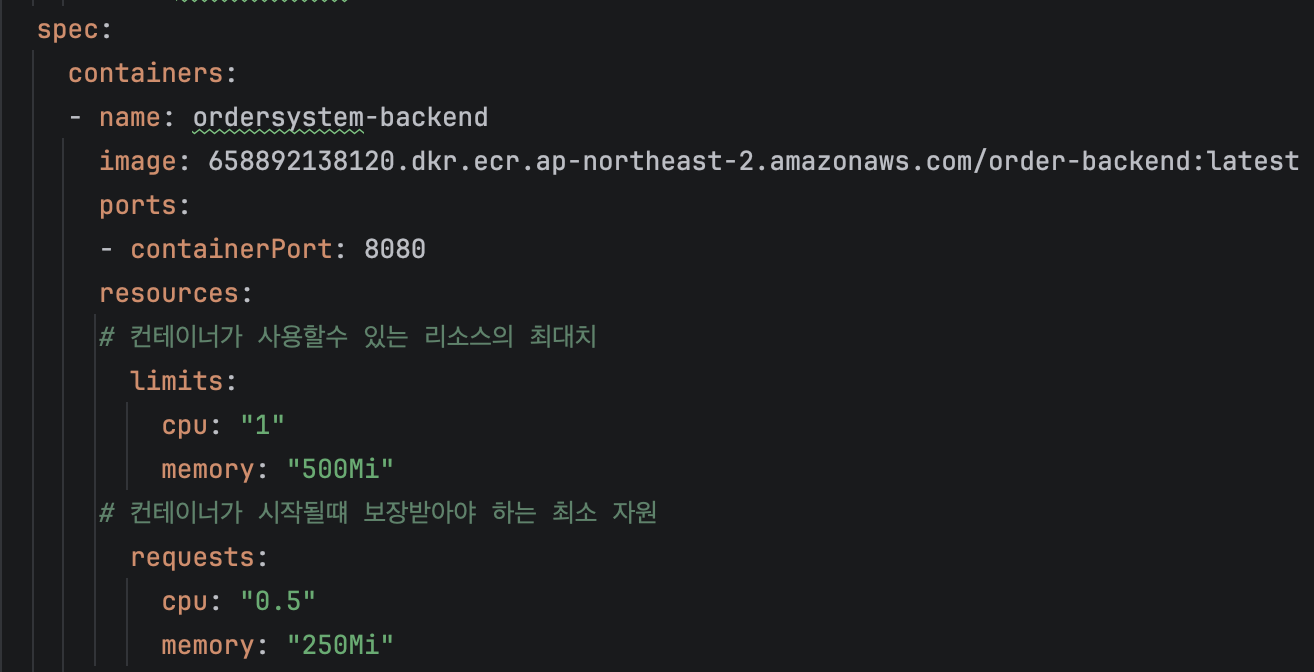
1. Deployment 설정
- pod에 리소스 사전 제한 설정이 필요하다.
- pod가 생성/삭제되는 과정에서 큰 부하가 발생해 cpu가 튈 수 있으므로 HPA와 resource limit의 cpu를 여유롭게 셋팅해야 한다.
2. 메트릭 서버 설치
- HPA가 파드(Pod)의 리소스 사용량을 모니터링하고, 이를 기반으로 자동 확장을 수행할 수 있도록 필요한 메트릭 데이터를 제공한다.
- kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/download/v0.6.3/components.yaml
3. HPA 스크립트 생성 후 적용
- HPA 서버는 파드를 모니터링하다가 확장이 필요하면 Deployment에 명령한다. (Deployment의 설정보다 우선)
- HPA를 통한 파드 현황 조회: kubectl get hpa order-backend-hpa -w(watch)
- 스케일업은 비교적 빠른데 스케일다운은 느리다.
순간적인 사용량 하락에 바로 반응해 파드를 줄였다가 다시 늘리는 flapping을 방지하기 위함이다. - behavior 속성: 잦은 스케일링 방지 목적. CPU가 순간적으로 크게 올라갈 때 바로 증설x, "몇분 정도 유지 시 증설한다" 설정
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0        # 스케일업은 지연 없이 즉시 반응
      policies:
      - type: Percent
        value: 100                          # 현재 replica 수의 100%까지
        periodSeconds: 15                   # 15초마다 이 정책 적용 가능
      - type: Pods
        value: 4                            # 또는 최대 4개까지
        periodSeconds: 15
      selectPolicy: Max                     # 두 정책 중 더 큰 쪽(더 공격적인 쪽) 채택
    scaleDown:
      stabilizationWindowSeconds: 300        # 스케일다운은 5분간 관망(가장 중요)
      policies:
      - type: Percent
        value: 10                           # 한 번에 최대 10%씩만
        periodSeconds: 60
      selectPolicy: Min                     # 더 보수적인(작은) 쪽 채택
EC2 Auto Scale
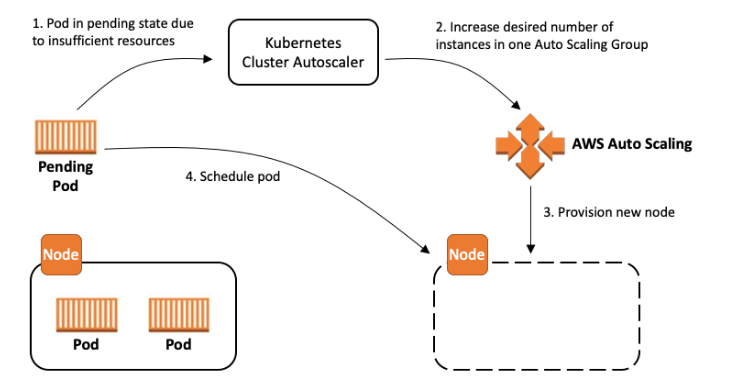
Cluster-Autoscaler
- 클러스터에서 노드의 수를 자동으로 조절해주는 프로그램
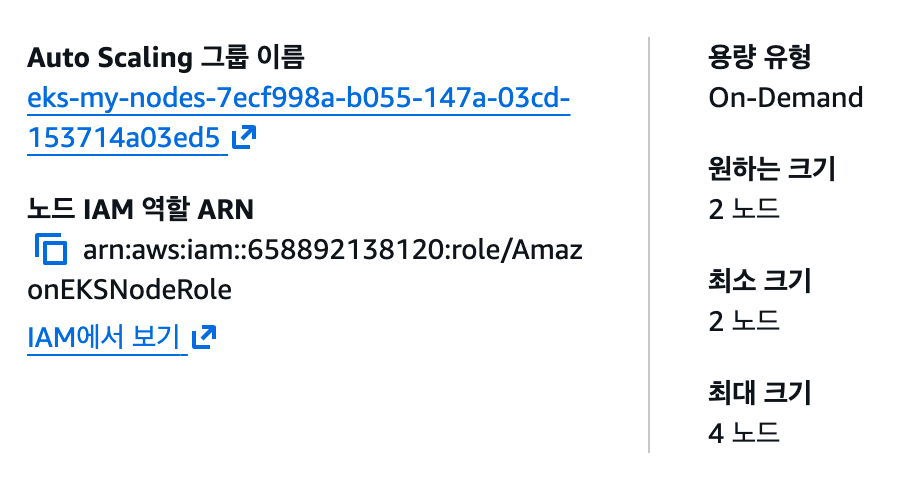
- 자원 사항을 인지하고 Node(EC2) 개수를 AWS EC2 Auto Scaling Group에 노드 수 증가/감소 요청
적용 절차 개요
- NodeGroup(ASG)에 태그 추가
- 해당 ASG가 클러스터 오토스케일러의 관리 대상이라는 것을 표시 - EKS, ASG 등에 접근할 수 있는 IAM 역할 생성 및 autoscaler pod에 역할 부여
- EKS 및 EC2 ASG에 접근하여 노드를 자동으로 증감시킬 수 있도록 설정
- IAM 역할은 EC2, RDS 등과 같이 서비스 단위인 엔티티에 부여할 수 있음.
- 따라서 autoscaler pod를 엔티티로 등록해야 함. 그러기 위해선 신뢰할 수 있는 자원이라는 것을 EKS가 발급한 ID를 이용해 등록
- EKS를 ID 제공업체로 등록해야 함. - cluster-autoscaler pod 실행
- yml 파일을 다운로드하여 role, 클러스터명 등 수정
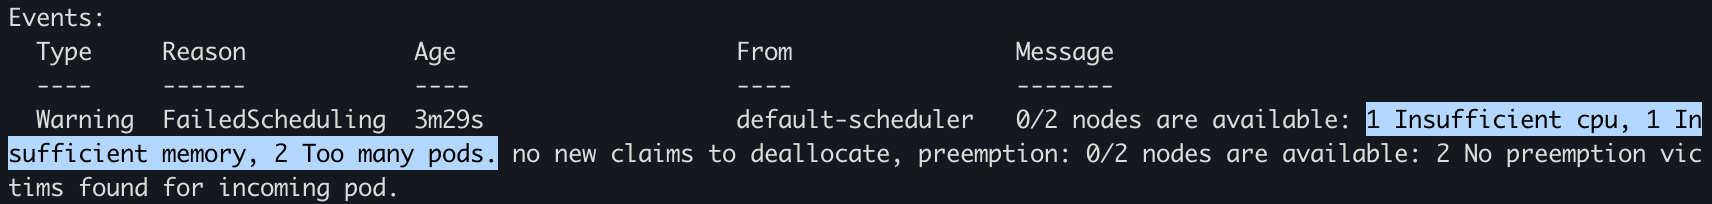
위와 같이 셋팅 후 부하 테스트를 해보면, 파드를 생성하다가 더 만들지 못하고 pending 상태가 되는 것을 확인할 수 있다.
pending 상태의 파드는 뜨질 못했으므로 로그가 남지 않는다. describe로 상태를 보면 아래와 같이 자원이 부족해 생성하지 못했다.
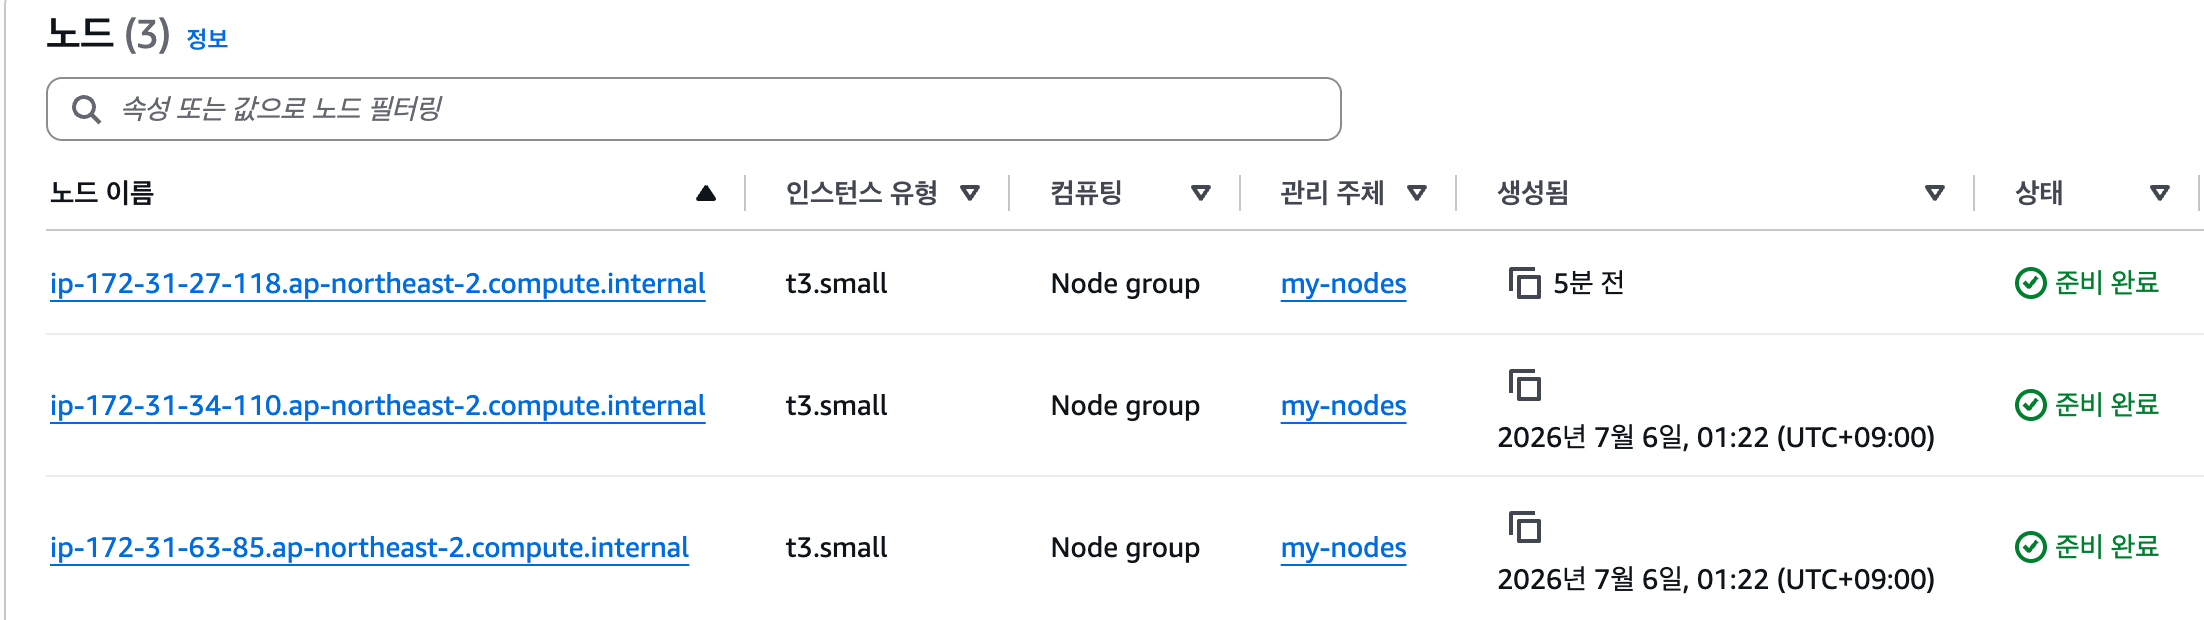
좀 더 기다리면 아래와 같이 노드가 추가된 것을 확인할 수 있다.
참고 자료 & 이미지 출처
EKS를 활용한 Spring 운영서버 배포 (feat. devops의 모든 것)
'Infra > Kubernetes' 카테고리의 다른 글
| EKS를 이용한 Spring Cloud MSA 서버 배포 (0) | 2026.07.19 |
|---|---|
| Argo CD, 프로메테우스/그라파나 (0) | 2026.07.17 |
| 쿠버네티스 아키텍처와 리소스 (0) | 2026.07.05 |
| EKS를 활용한 Spring 운영 서버 배포(Monolithic) (0) | 2026.07.03 |
| AWS EKS를 활용해 서버 배포하기 (0) | 2026.02.04 |