- 분류 전체보기 (221)

| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- securitycontextholderfilter
- Helm
- Spring
- @Transactional
- 스프링 부트
- Iam
- JPQL
- Secret
- redis
- k8s
- Web
- AWS
- argocd
- Spring Data JPA
- dockerhub
- JdbcTemplate
- docker
- CORS
- 컨테이너
- 쿠버네티스
- 페이징
- 도메인
- JPA
- mybatis
- JWT
- DI
- Spring Container
- cicd
- MSA
- kafka
- Today
- Total
look-forest
Label/Selector, Probe 본문
리소스 전체 개요
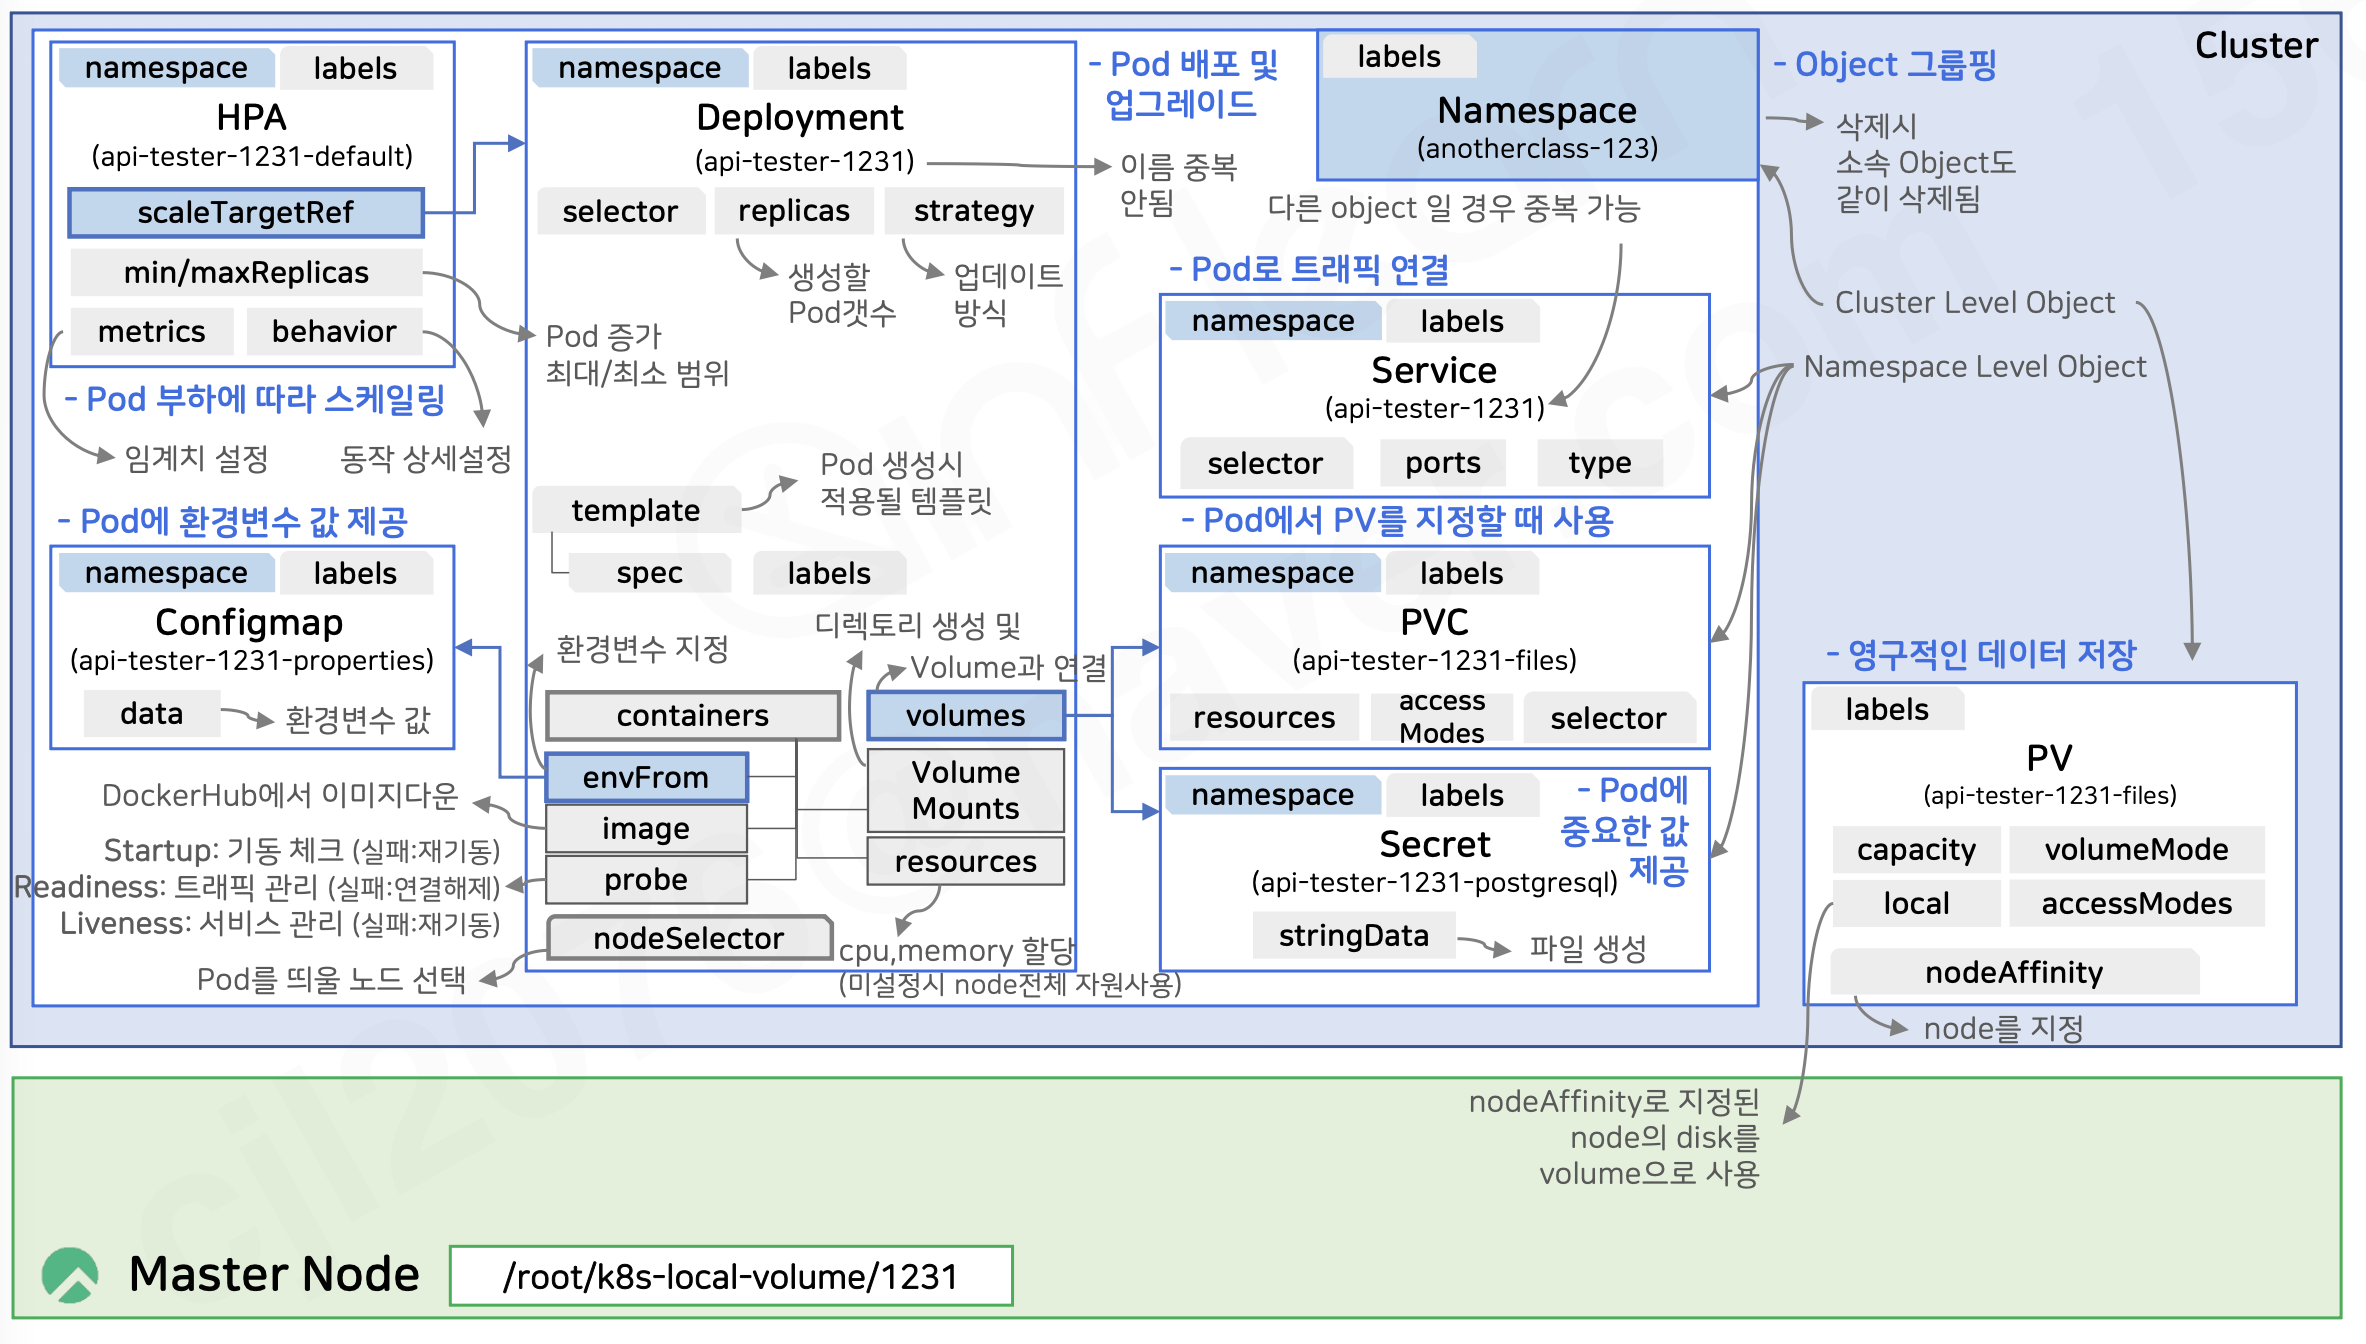
- Object는 크게 클러스터 레벨, 네임스페이스 레벨로 나뉜다
- Namespace, PV는 클러스터 레벨이고, Pod 등은 네임스페이스 레벨이다.
- Namespace를 지우면 구성 Object들이 모두 삭제된다.
- HPA의 behavior: "증설 직후 10분간은 (CPU가 튈 수 있으므로) 파드를 늘리지 않는다" 등을 설정
labels/selector/naming
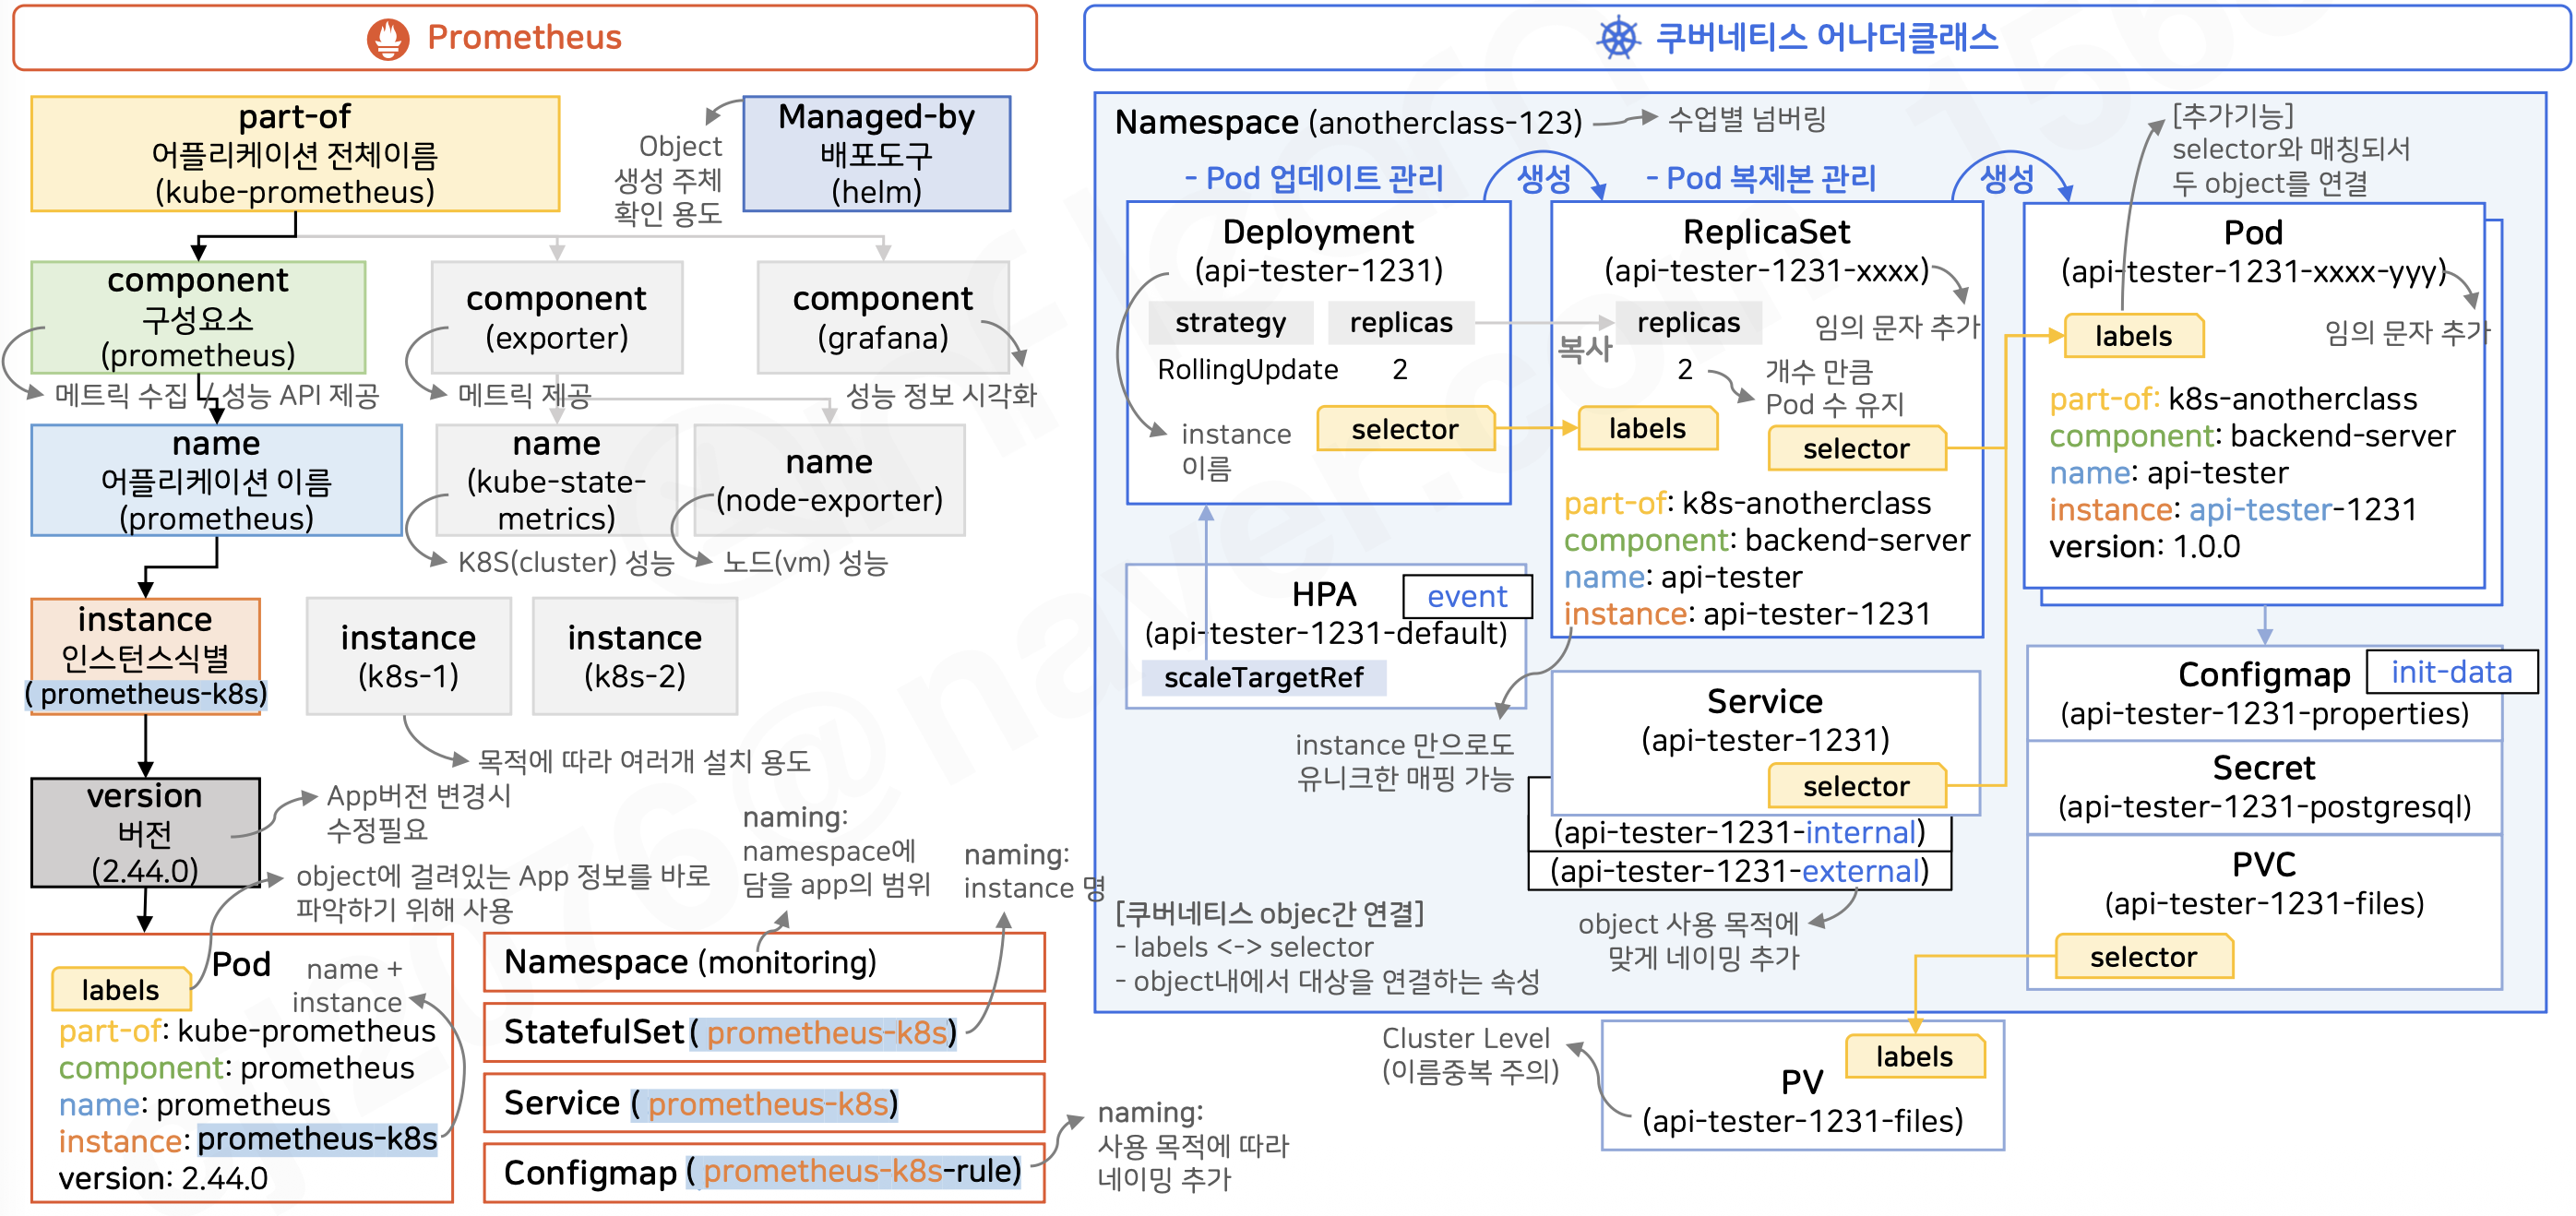
잘 만든 오픈소스들은 Label만 봐도 이 Pod가 전체 마이크로서비스 구조에서 어느 위치에 있고, 어떤 역할을 하는지 바로 감이 올 수 있게 만들었다. 이 시스템을 처음 보는 동료가 Label만 보고도 맥락을 이해할 수 있도록 만들자.
- label
- part-of: 어떤 어플리케이션의 요소인가
- component: 어떤 기능을 맡았나
- name: 고유한 이름
- instance: name이 class에 해당하고, instance가 그 class로부터 만들어진 구체적인 배포 하나에 해당
- managed-by: Object 생성 주체
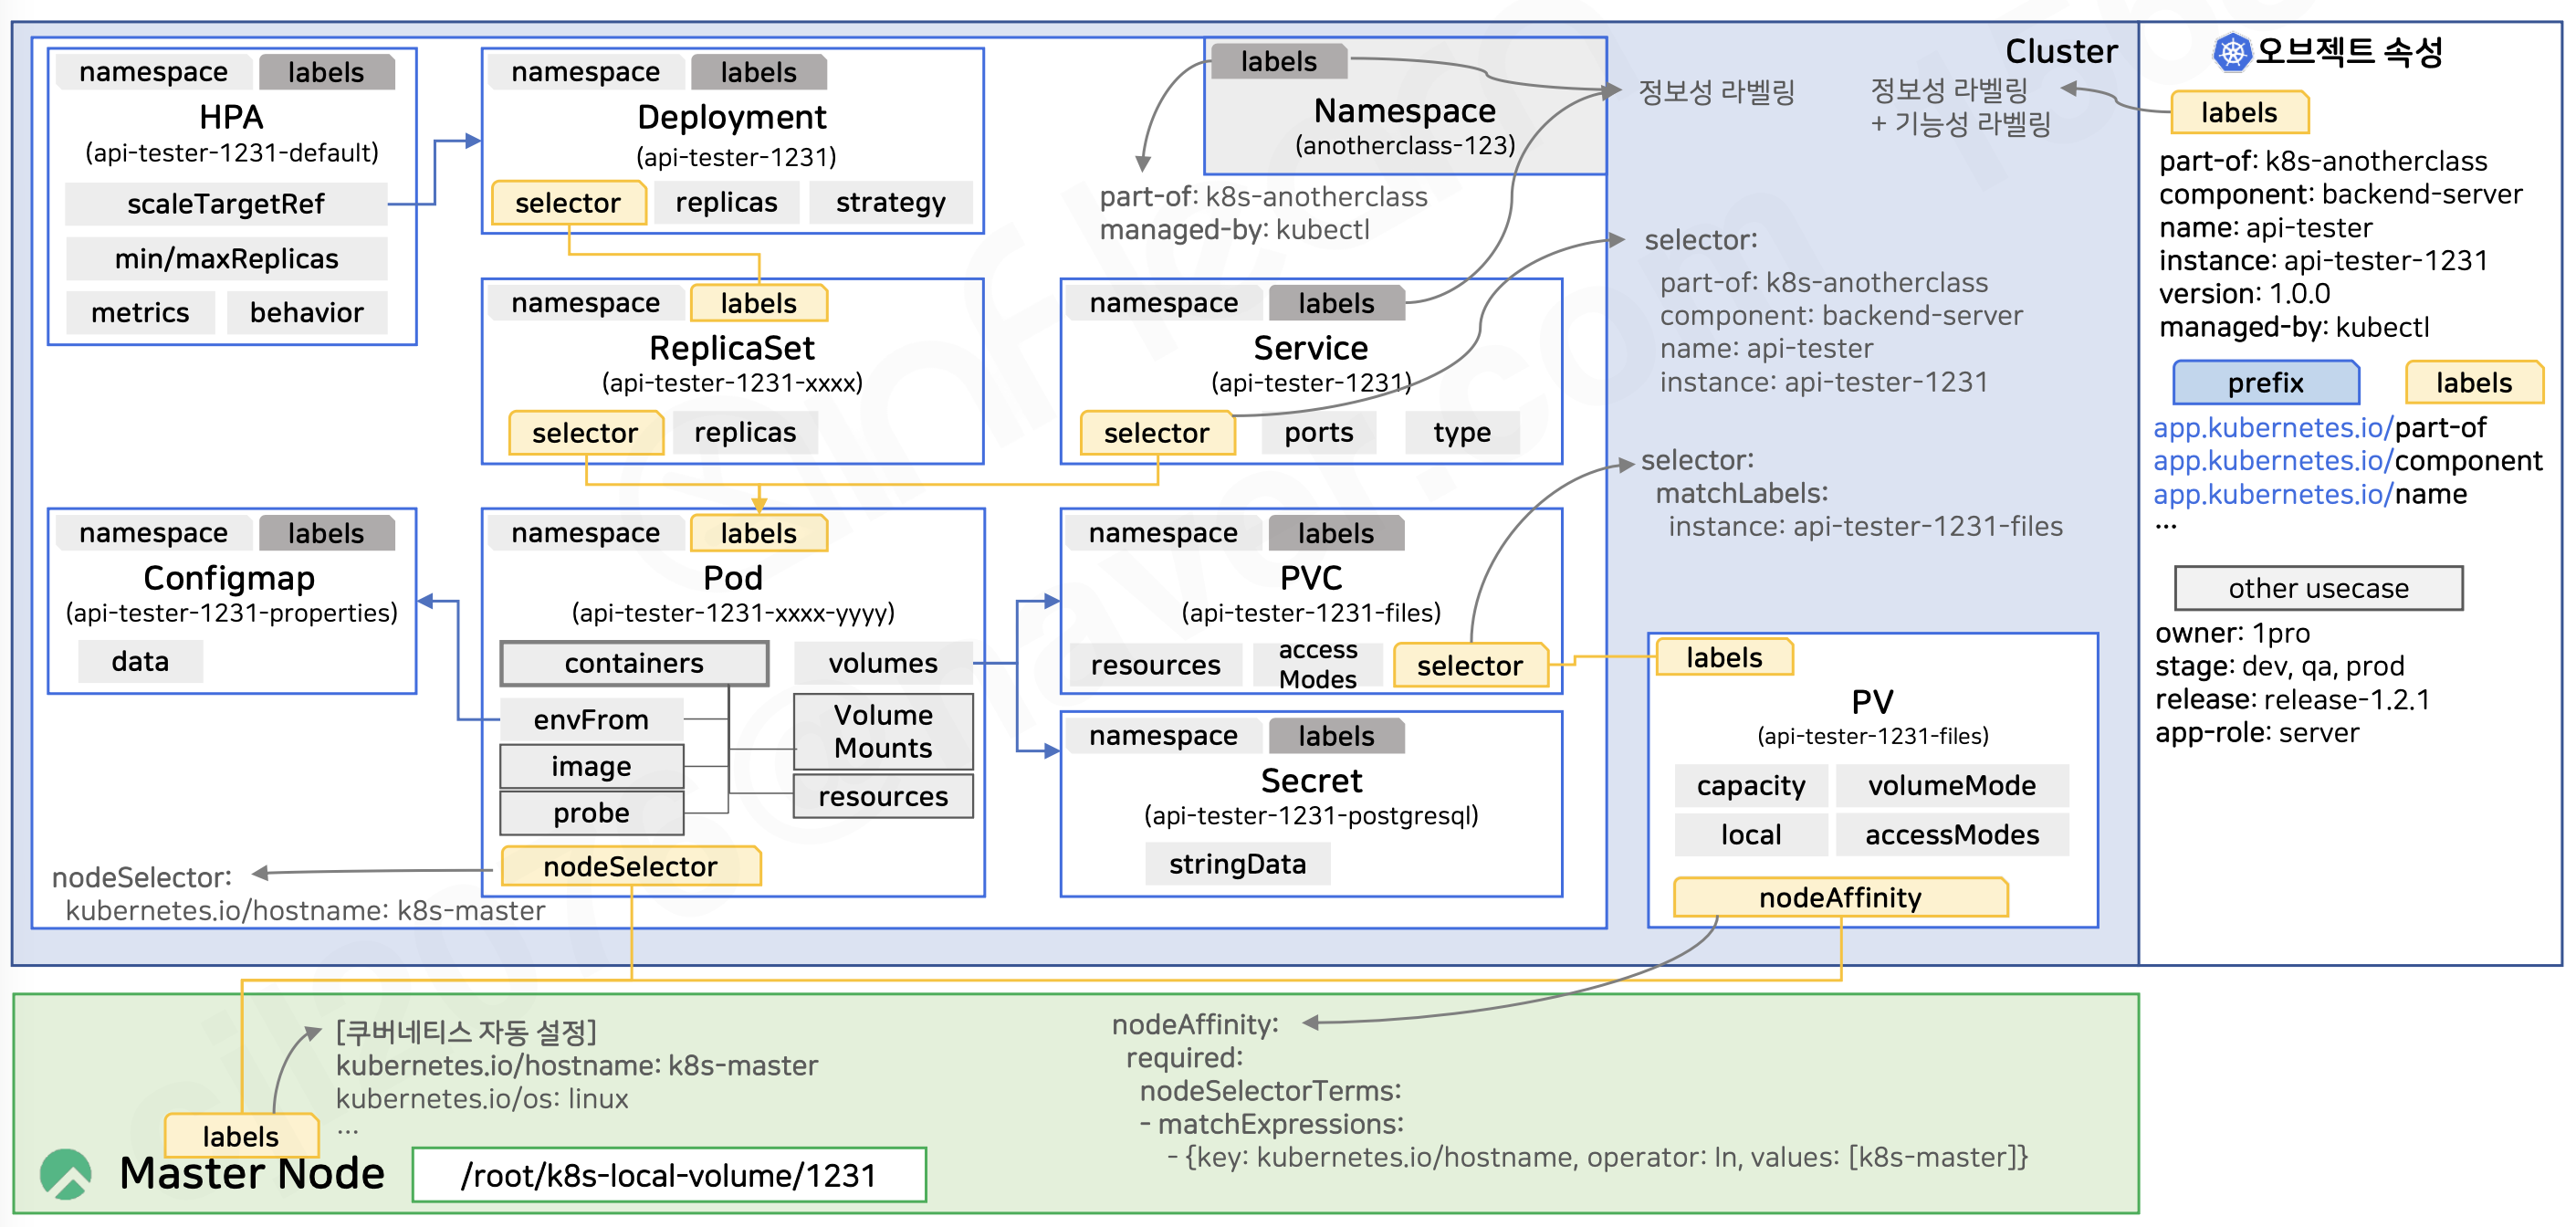
- selector
- label과 함께 사용해서 object 연결
- Selector에 정의된 모든 내용이 대상 오브젝트의 Label에 포함되어 있어야 정상적으로 연결이 이루어진다.
Label Selector는 오직 label 기반으로 Pod을 선택하며, 이름(Name)은 매칭에 사용되지 않는다.
Probe
Probe는 파드 속성 중 하나로, 상태를 확인하기 위한 검사(탐침)을 한다.
Startup, Readiness, Liveness 3가지 종류가 있다.
startupProbe가 성공하여 기동이 확인된 이후에야 readinessProbe와 livenessProbe가 본격적으로 동작을 시작한다.
readinessProbe는 App이 기동된 후 트래픽을 받을 준비가 되었는지 체크하며, 실패 시 해당 Pod를 서비스에서 제외하여 외부 연결을 차단한다.
| 프로브 | 질문 | 실패 시 동작 |
| liveness | "이 프로세스가 정상적으로 살아있나?" (데드락, 무한루프 등) | 컨테이너 재시작 |
| readiness | "지금 트래픽을 받을 준비가 됐나?" (의존성, 워밍업, 부하) | Service의 엔드포인트에서 제외 (트래픽 차단, 재시작 안 함) |
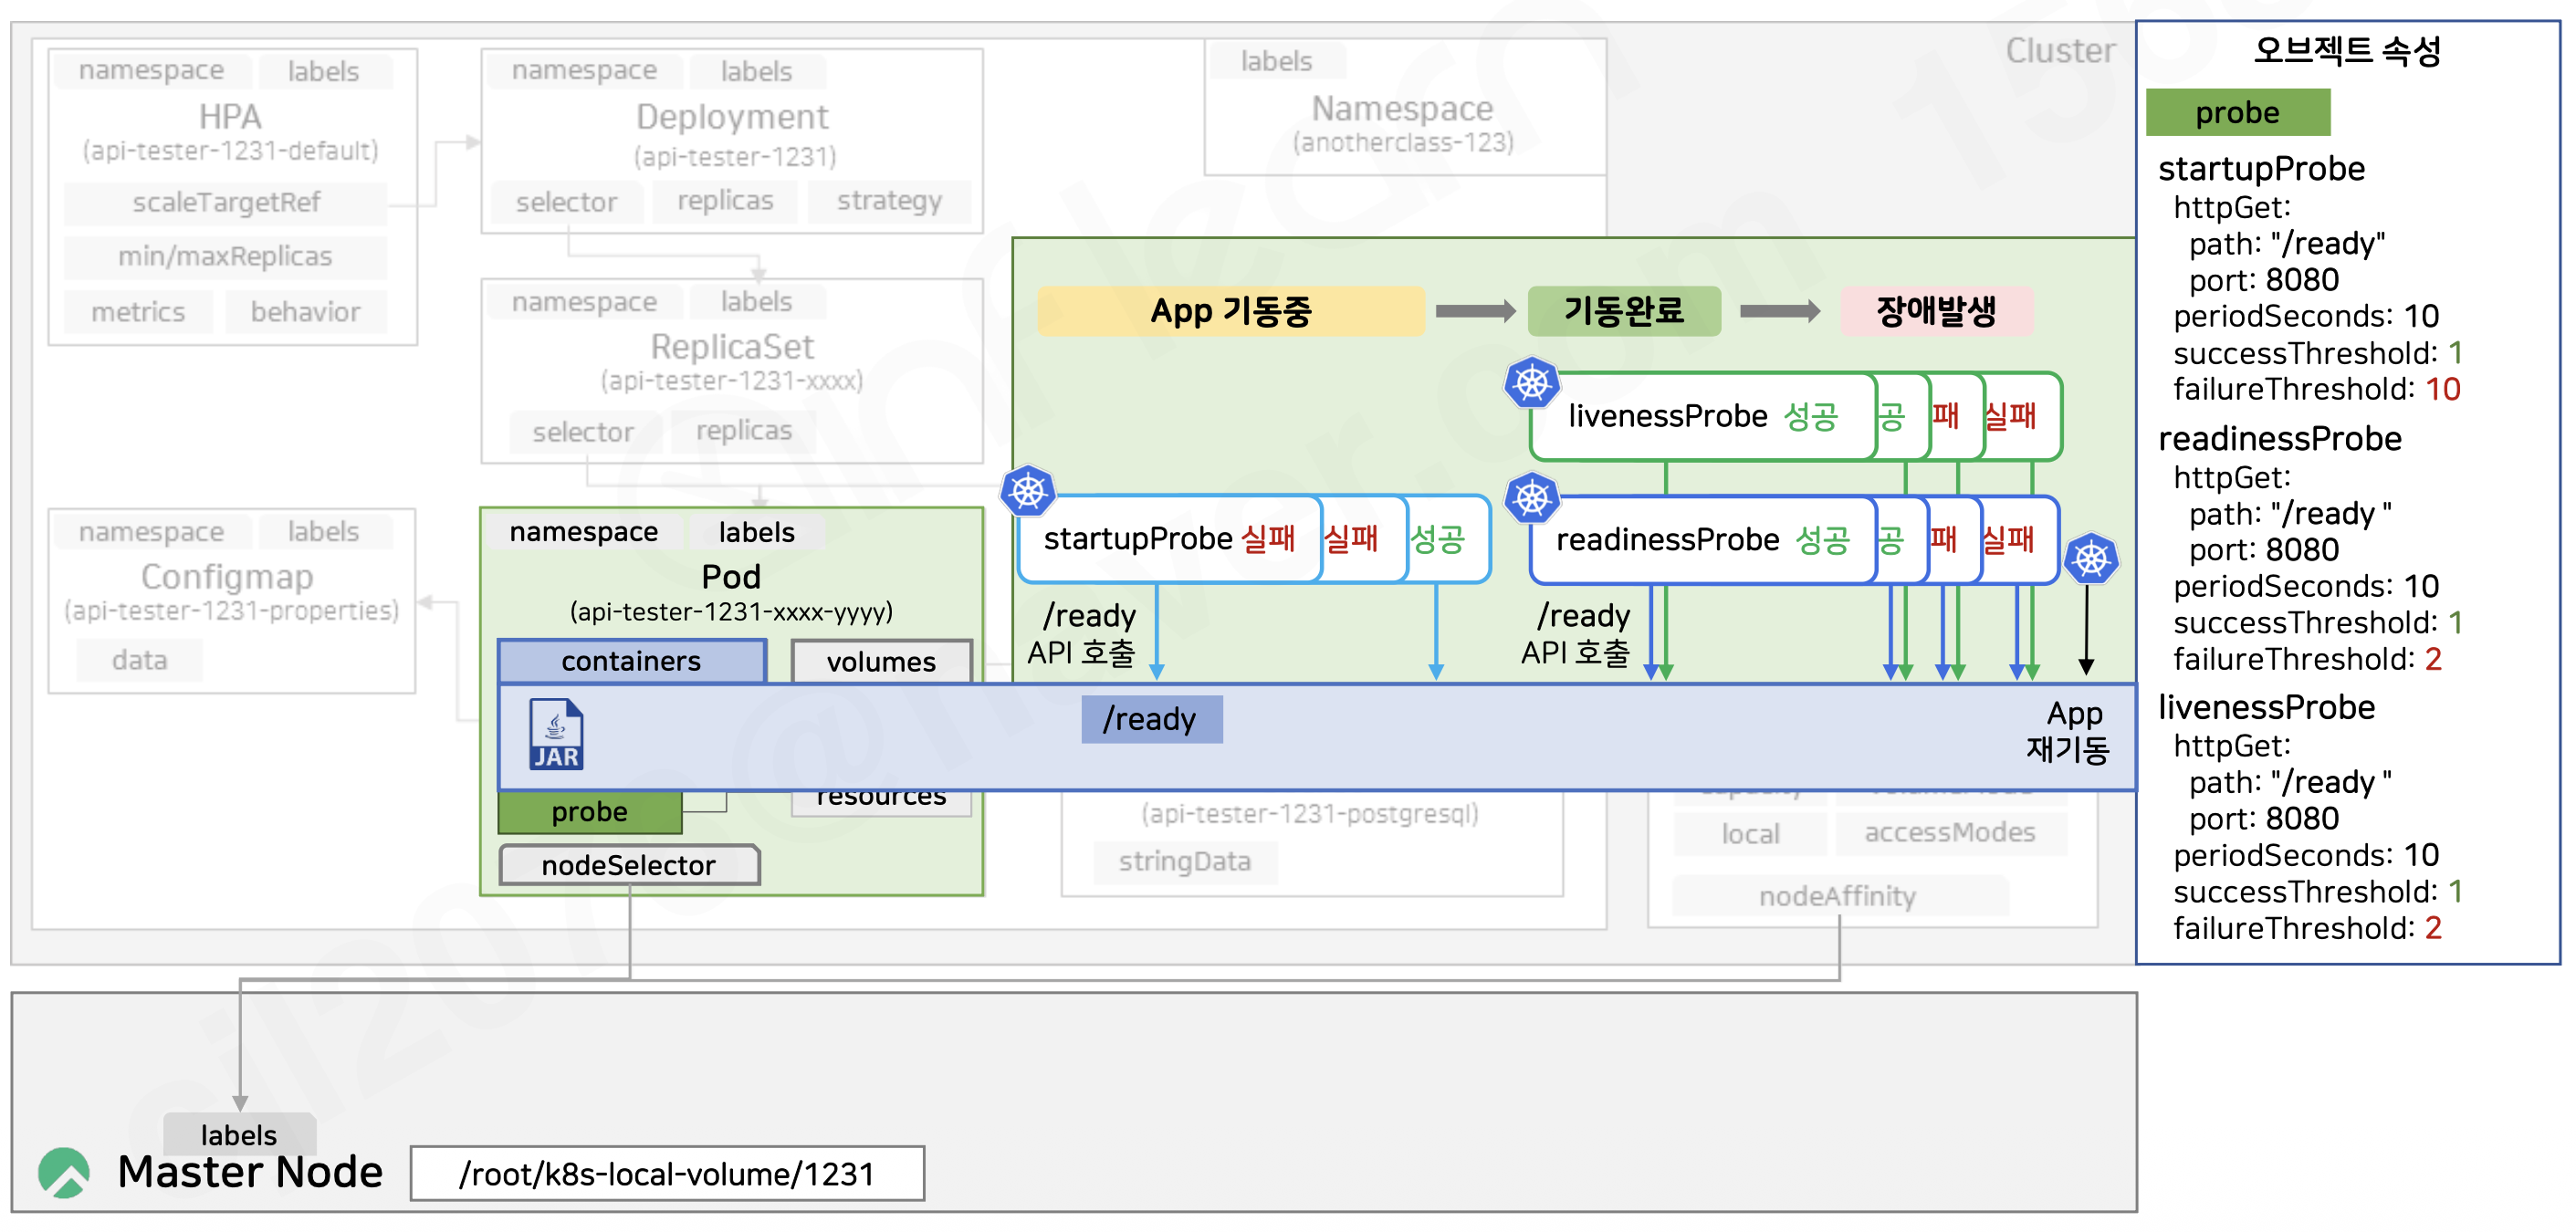
Application 동작 중심의 프로브 이해
전체 흐름
[Pod 시작]
│
▼
startupProbe 시작 ──(실패)──▶ periodSeconds마다 재시도 ──(failureThreshold 초과)──▶ 컨테이너 재시작
│
(성공)
│
▼
startupProbe 종료, 이 시점부터 livenessProbe / readinessProbe 동시에 각자 독립 스케줄로 시작
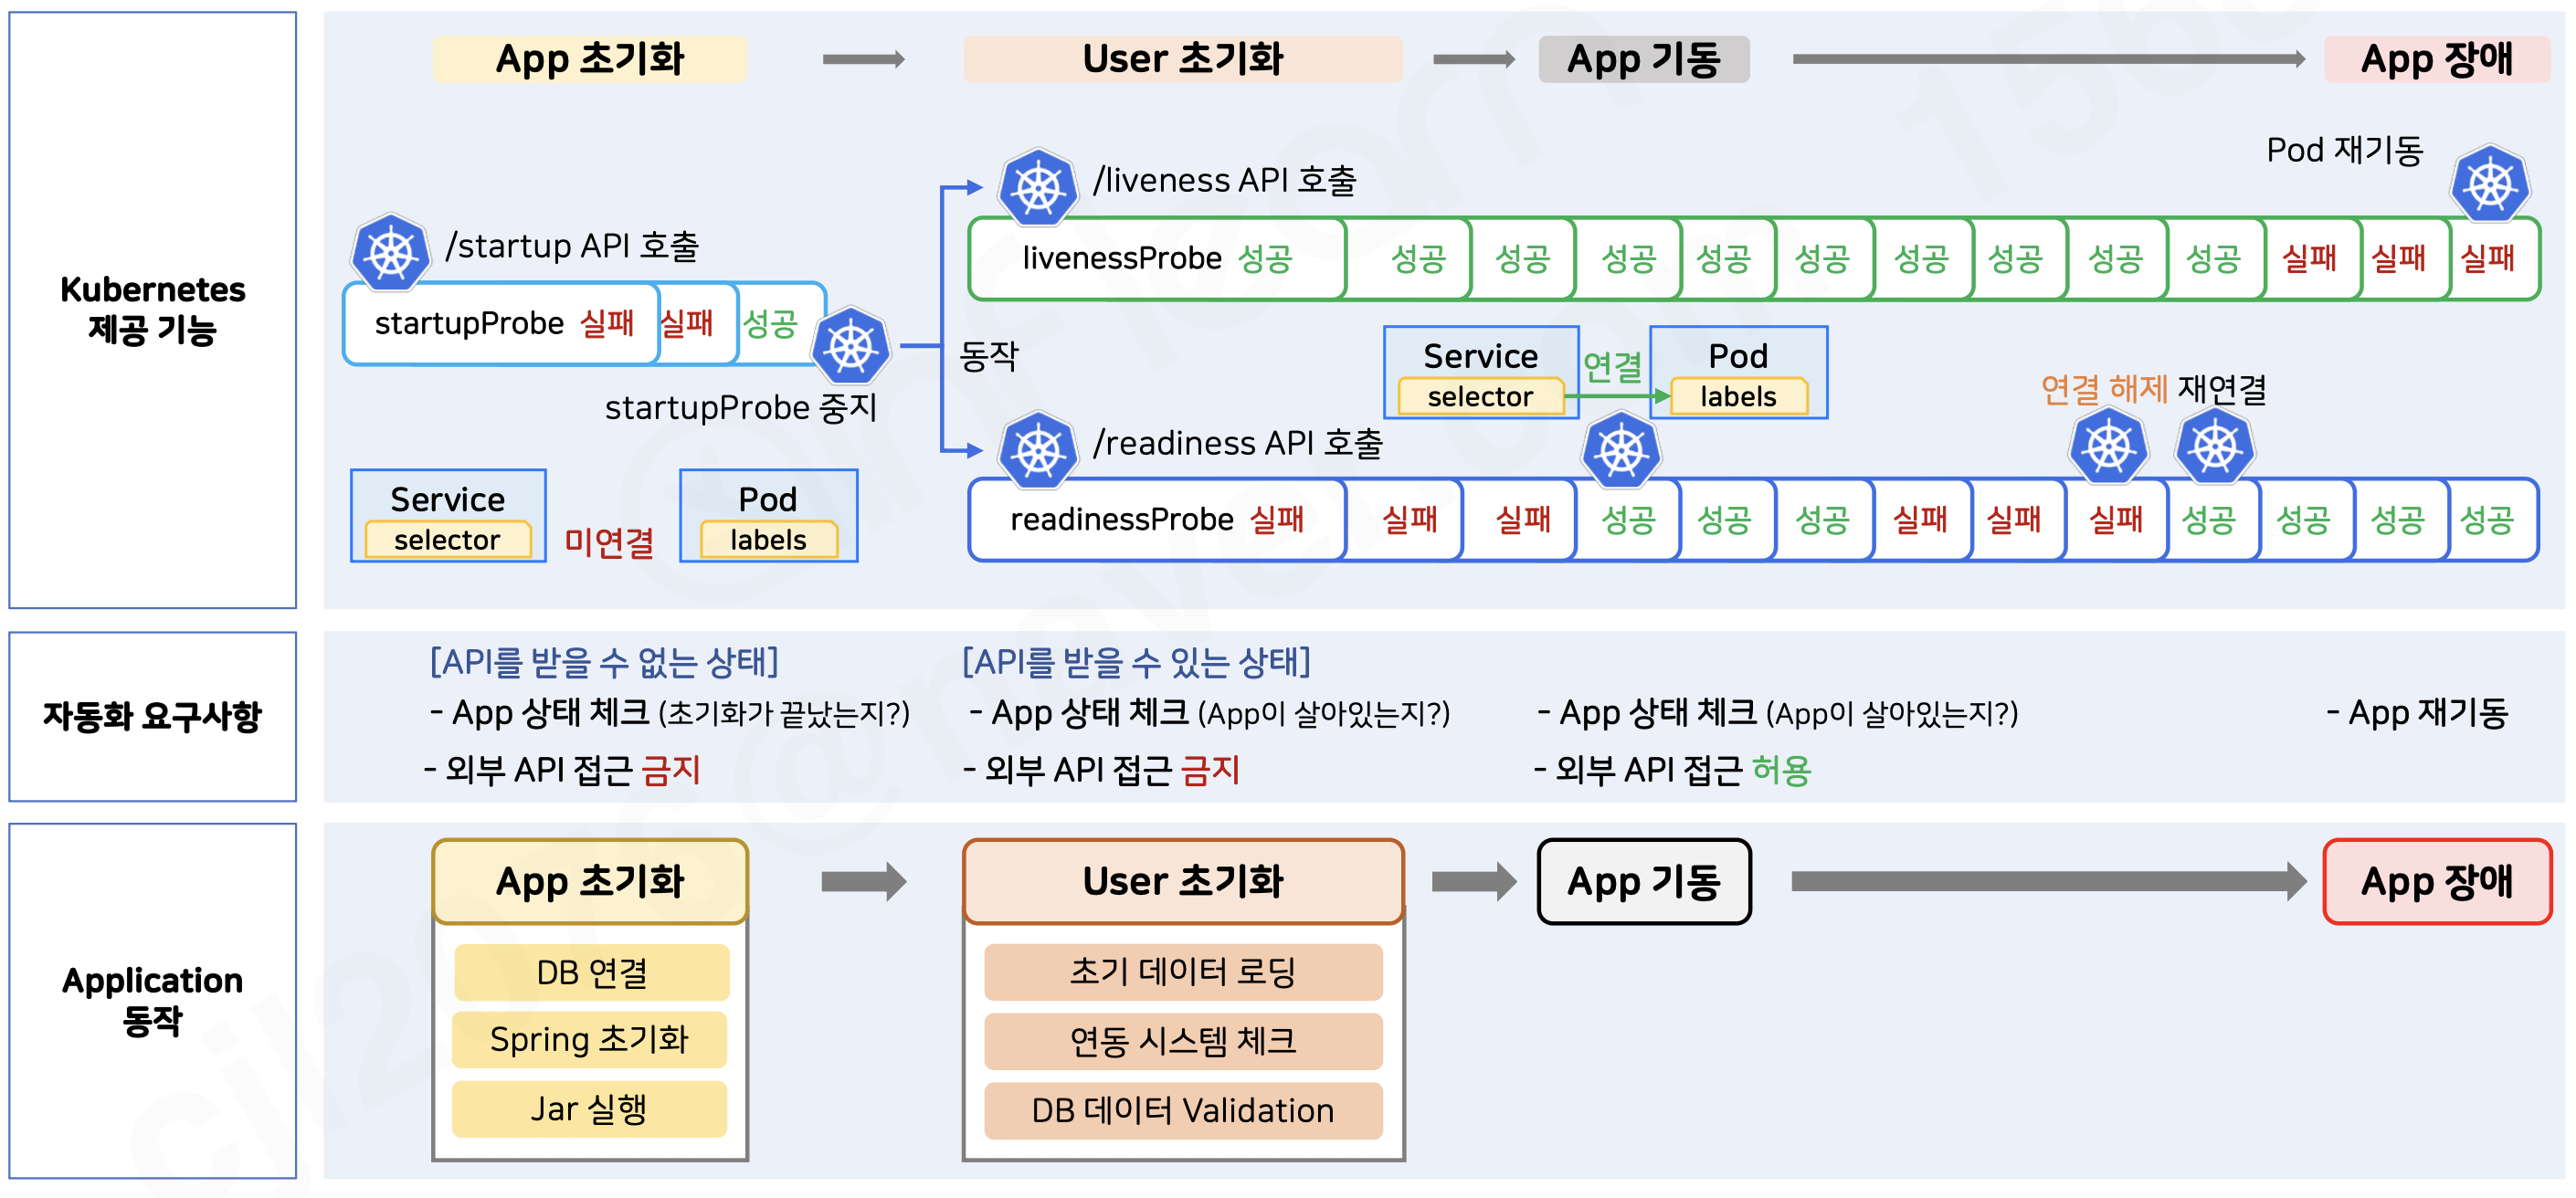
liveness는 "죽었으면 재시작", readiness는 "준비 안 됐으면 트래픽 차단"이고, 둘은 목적이 달라서 분리되어 있으며
URL은 같아도 되고 달라도 되지만 응답 로직은 서로 다르게 짜야한다.
왜 나뉘어져있을까?
이 둘을 하나로 합치면 죽는 경우가 생겨서 분리되었다. 대표적 예시가 DB 커넥션 풀 고갈
- 앱은 살아있음(프로세스 정상, liveness는 성공해야 함)
- 근데 DB 연결이 꽉 차서 요청을 처리 못 함(트래픽은 받으면 안 됨, readiness는 실패해야 함)
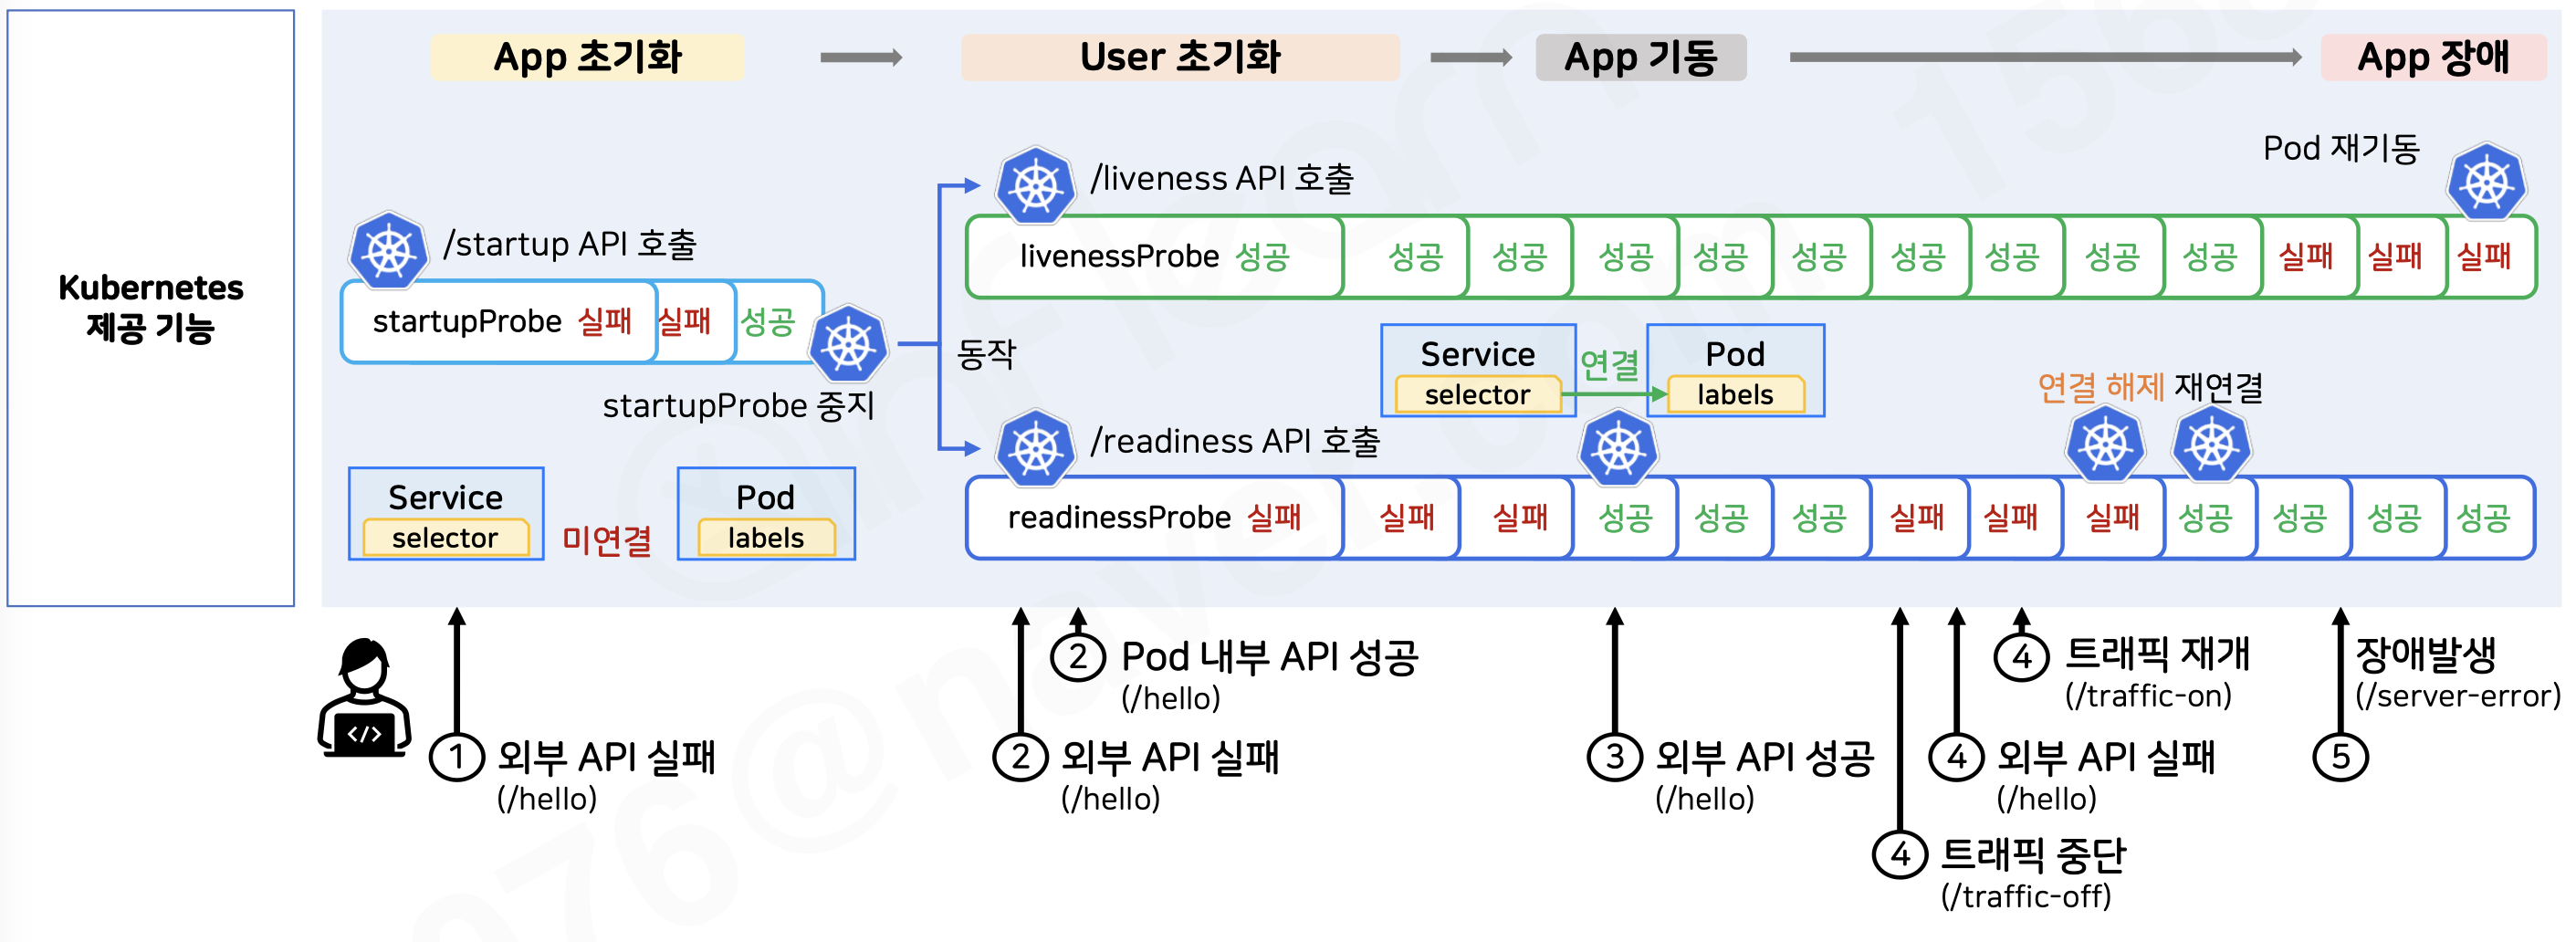
원리
아래 샘플 코드와 같이 각 프로브에서 호출할 엔드포인트가 구현되어 있어야 한다.
- 사실 아래는 이해를 돕기 위한 예시일뿐, 실제로 개발하진 않는다.
Spring Boot Actuator는 "Application Availability State"라는 내부 상태값을 통해 liveness/readiness를 자동으로 관리하고, 이걸 HTTP 엔드포인트로 노출해줘서 개발자가 직접 헬스 체크 로직을 짜지 않아도 기본 동작이 되게 해준다.
단, 쿠버네티스 환경에서만 이게 자동 활성화된다. - readiness, liveness 프로브는 계속 호출되니까 가볍게 만들어야 한다.
@RestController
public class HealthController {

    private final DataSource dataSource;
    private volatile boolean started = false;

    @EventListener(ApplicationReadyEvent.class)
    public void onReady() {
        this.started = true;   // 시작 완료 신호
    }

    @GetMapping("/healthz")   // liveness — 프로세스 생존만 확인
    public ResponseEntity<String> liveness() {
        return ResponseEntity.ok("OK");
    }

    @GetMapping("/readyz")    // readiness — 트래픽 처리 가능 여부
    public ResponseEntity<String> readiness() {
        if (!started) {
            return ResponseEntity.status(503).body("STARTING");
        }
        try (Connection conn = dataSource.getConnection()) {
            if (conn.isValid(2)) {
                return ResponseEntity.ok("READY");
            }
        } catch (SQLException e) {
            // fall through
        }
        return ResponseEntity.status(503).body("DB DOWN");
    }
}
일시적인 장애 상황에서의 프로브 활용
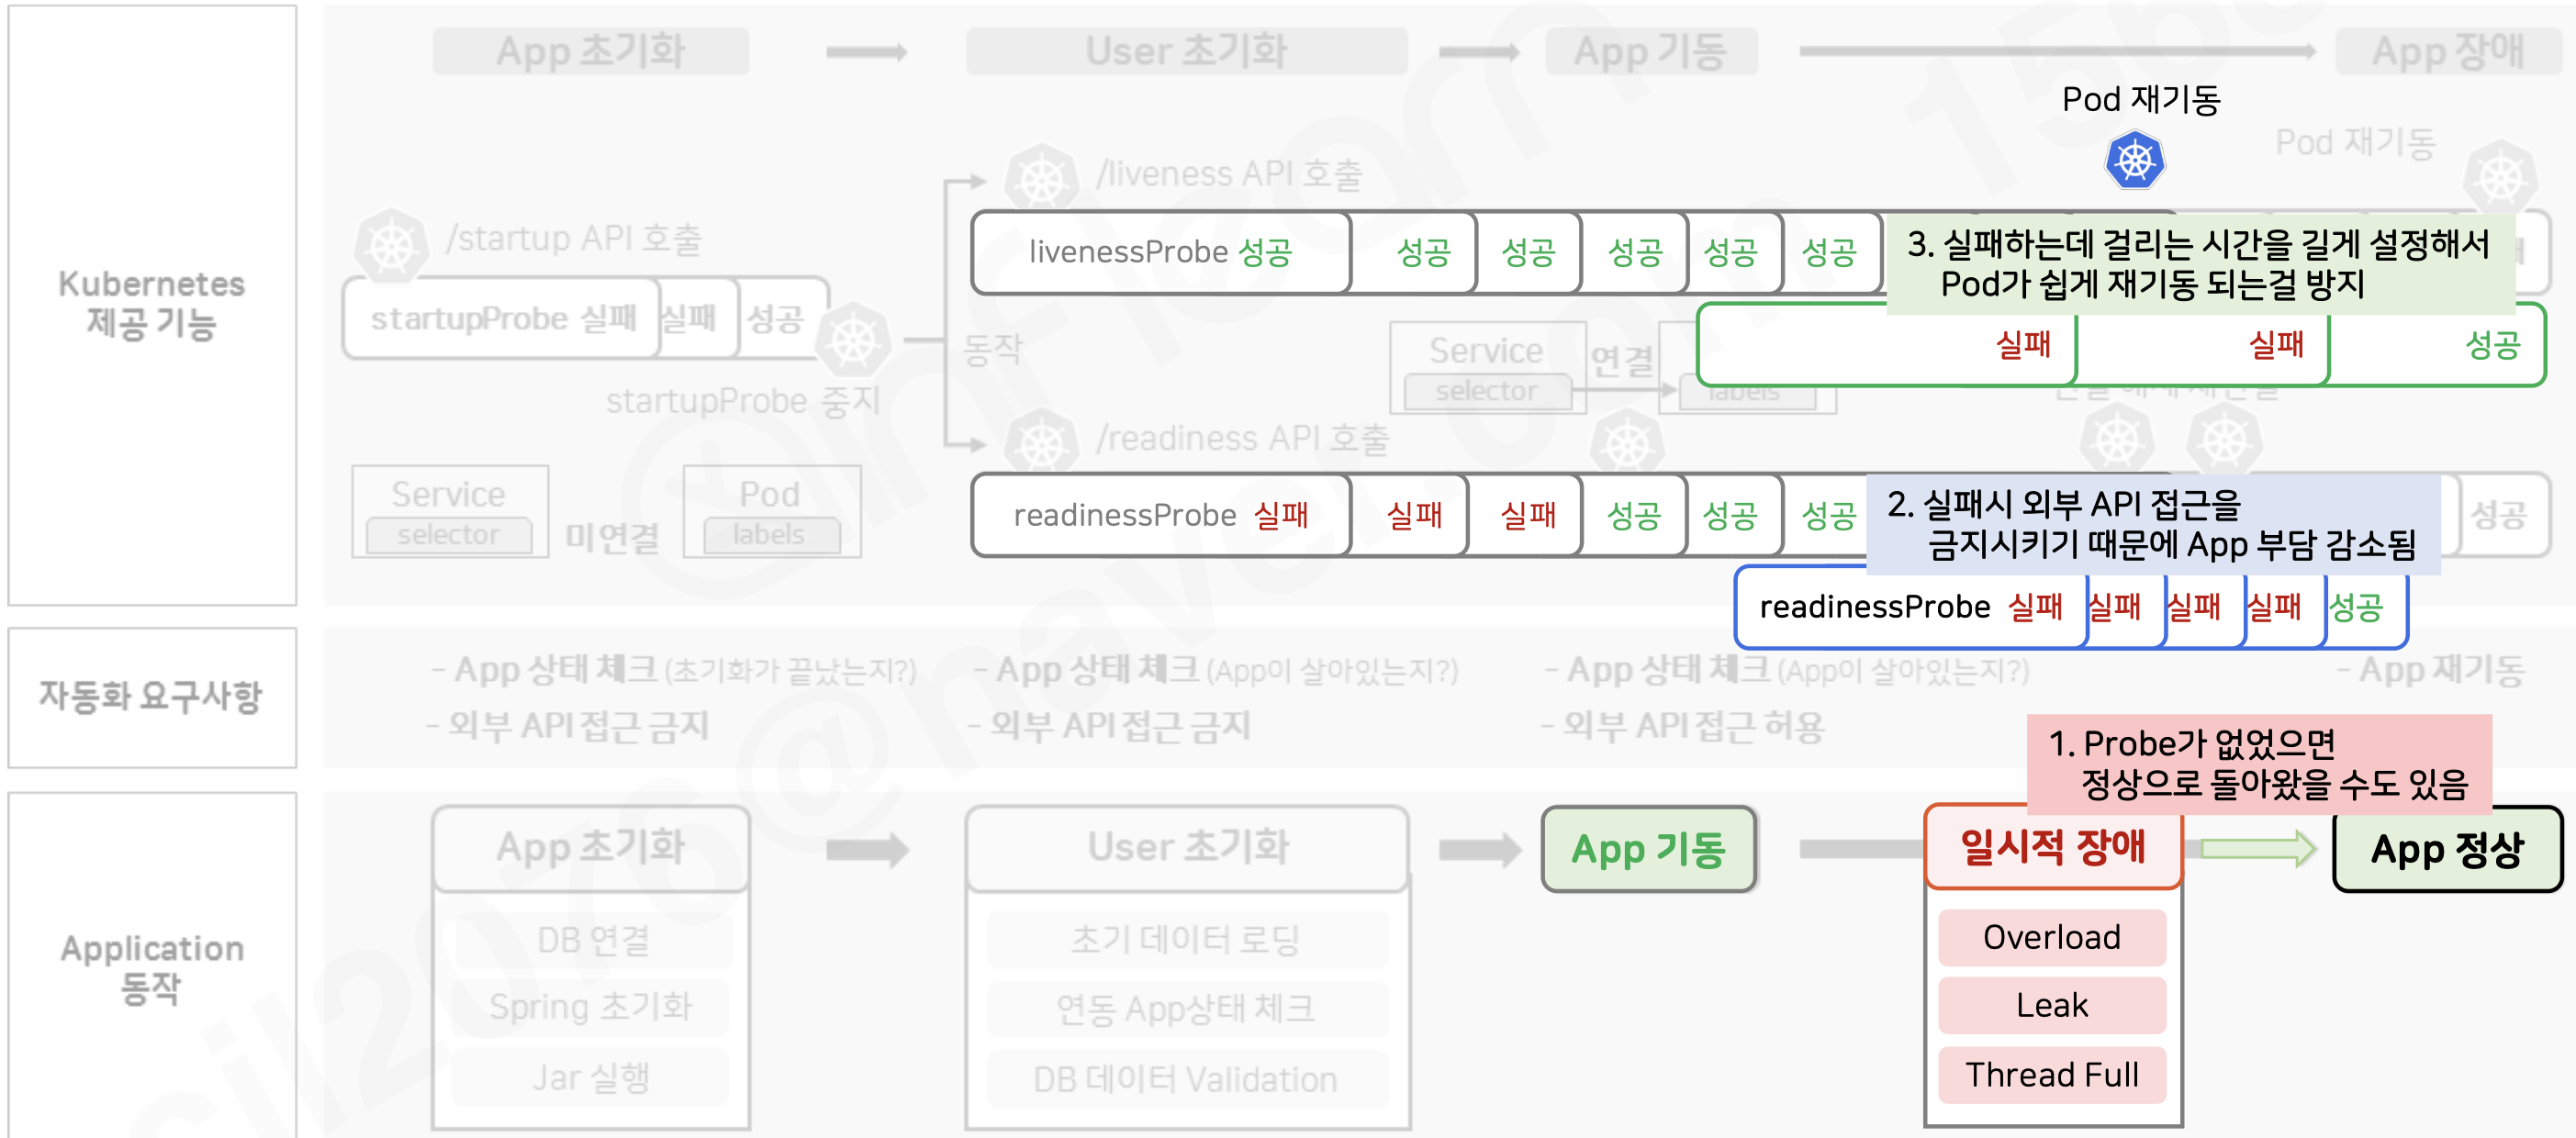
가끔 일시적으로 장애가 발생할 수 있는데, 잠시 뒤면 해결될 것을 프로브 때문에 파드를 재생성하게 될 수도 있다.
readiness 프로브는 오히려 도움이 된다. 트래픽을 끊어주니까.
liveness 프로브가 문제인데, 이를 막으려면 liveness 프로브의 체크 주기를 길게하면 된다.
readiness는 실패해서 트래픽을 더 받지 않도록 하되, liveness는 아직 성공이라 파드 재기동을 하지 않는 상태를 유지하는 것이다.
참고 자료 & 이미지 출처
쿠버네티스 어나더 클래스-Sprint 1, 2
'Infra > Kubernetes' 카테고리의 다른 글
| 쿠버네티스 무게감있게 설치하기, 트러블슈팅 (0) | 2026.07.26 |
|---|---|
| 컨테이너 한방 정리 (0) | 2026.07.25 |
| EKS를 이용한 Spring Cloud MSA 서버 배포 (0) | 2026.07.19 |
| Argo CD, 프로메테우스/그라파나 (0) | 2026.07.17 |
| Auto Scale (Pod/Node) (0) | 2026.07.17 |